BUYMAのエンジニア組織はどう進化した?AI駆動時代の開発体制を紹介します

はじめに

こんにちは!エニグモの採用広報担当です。

本記事では、現在のプロダクト開発チームの体制や組織を横断した意思決定の仕組み、そしてAI駆動開発をはじめとする現在のエニグモの開発環境について紹介します。

エニグモが前回、開発組織の変更発表を行ったのは3年前の2023年のことです。 当時は『チームトポロジー』の考え方を取り入れつつ、Domain・Squad・Chapterをベースとした体制へと大きく転換しました。 それから約3年、生成AIをはじめとするテクノロジーの劇的な進化に伴い、開発スタイルや組織に求められる役割も目まぐるしく変化してきました。

今年2026年4月には、サービスエンジニアリング本部 部長の木村より、今後目指していくエンジニア組織のビジョンを発表しています。 (参考:AI駆動開発とベンチャー回帰で創る次世代エンジニア組織)

今回は、前回の記事を3年ぶりにアップデートし、掲げられた「AI駆動開発」や「フルスタック・フルサイクルな開発」を、現在の組織・開発体制の中でどのように実現しているのか、その具体像をお伝えします!

エンジニアが所属する組織について

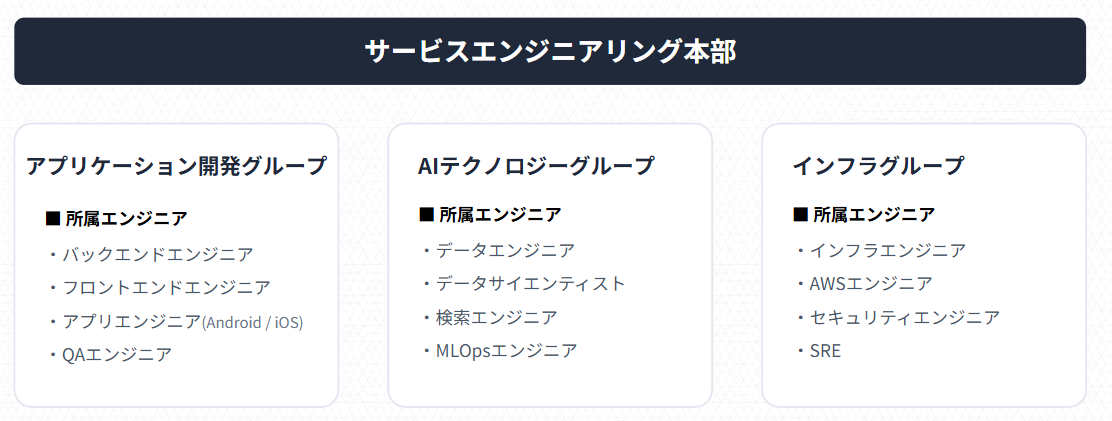
サービスエンジニアリング本部(以下、SE本部)は、エンジニアが所属する部署で、大きく以下の3つのグループで構成されています。

  • アプリケーション開発グループ:主力事業である「BUYMA」をはじめとしたプロダクトの機能開発を担当
  • AIテクノロジーグループ:AI・データ基盤・機械学習・検索などの専門領域を担当
  • インフラグループ:インフラ・セキュリティ領域を中心にプロダクト開発を支援

ここからは、実際の開発体制について詳しく紹介します。 エンジニアはいずれかのグループに所属していますが、日々の開発業務をグループ単位の縦割りで行っているわけではありません。実際のプロダクト開発では、所属グループの枠を越え、事業ミッションや専門性に応じてチームを組みながら活動しています。

プロダクト開発体制

BUYMAのプロダクト開発体制は、事業やユーザーへの提供価値を軸とした「Domain(ドメイン)」「Squad(スクワッド)」と、技術領域を軸とした「Chapter(チャプター)」という3つのチーム単位を設けています。

これらを独立した組織として分けるのではなく、エンジニアはDomain/Squadで事業課題に向き合いながらプロダクト開発を進め、同時にChapterを通じてチームを越えた技術的な取り組みも行う、マトリクス型の体制をとっています。

(※AIテクノロジーやインフラなど専門領域のメンバーは、このDomain/Squadでの開発を横断的に支援するチームとして機能しています。詳しくは後述します。)
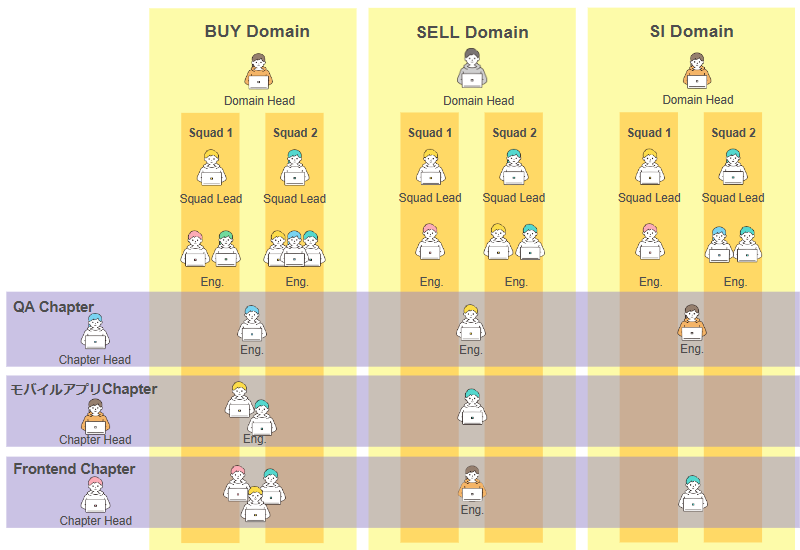
  それでは、マトリクス型の開発体制を構成するDomain/Squad/Chapterについて、それぞれ詳しく見ていきましょう。

■Domain(ドメイン)

Domainは、BUYMAにおける事業・ユーザーへの提供価値を軸に設定された開発領域です。

各Domainには、エンジニアだけでなく、ディレクター、データアナリスト、デザイナー、ビジネスサイドなど、さまざまな職種のメンバーが所属しています。共通のミッションや事業KPIを持ち、職種を越えて事業課題に向き合いながらプロダクト開発を進めています。

現在は、すべてのDomainがユーザーに直接価値を届ける「ビジネスミッション」を持つ体制への転換を進めています。

そのためエンジニアも、担当する機能を開発するだけではなく、事業KPIやユーザーへの提供価値を意識しながら、プロダクトや事業成果により深く関わることができます。技術だけでなく、事業視点を持ってプロダクト開発に携われることも、Domain体制の特徴です。

BUYMAには現在、以下の3つのDomainがあります。

BUY Domain ミッション:購入者を強力に吸い上げ、集客とCVRを最大化する。 主なカバー範囲:会員登録、商品詳細、購入リスト、レコメンド、クーポン、広告、特集ページ、カート、商品レビューなど。

SELL Domain ミッション:世界中から商品を力強く吸い上げ、品揃えを最大化する。 主なカバー範囲:出品ページ、出品リスト、受注リスト、商品画像、お問い合わせ、タイムセール、ショップ連携など。

SERVICE INFRA (SI) Domain ミッション:決済や安心補償などの機能を提供し、ユーザーへの提供付加価値を最大化する。 主なカバー範囲:決済連携、物流(配送・倉庫連携)、入金関連、セキュリティ関連など。

※大型キャンペーン対応、商品画像施策など、複数Domain横断のプロジェクトもあります。

■ Squad(スクワッド)

各Domainは、事業ミッション達成に向けて複数のSquadで構成されています。

Squadは、具体的な事業課題やプロジェクトを軸に組成され、その達成に必要なシステム開発にオーナーシップを持つチームです。 例えば、BUY Domainには「集客・流入Squad」「CVR Squad」、SI Domainには「配送Squad」などがあり、それぞれのテーマに沿って開発を進めています。   各Squadにはチームをリードする「Squad Lead」が存在し、要件の設計やタスクへの落とし込み、プロジェクトマネジメントなどを担います。 また、Squadでは設計・開発・テスト・リリースから運用・不具合対応まで、開発ライフサイクルを一貫して担当します。実装して終わりではなく、リリース後のユーザーの反応やデータを見ながら継続的に改善し、プロダクトを育てていけることも、Squadで開発する面白さのひとつです。

■ Chapter(チャプター) 

Chapterは、特定の専門領域を担当するメンバーが、Domain/Squadを横断して活動するチームです。

メンバーはそれぞれのSquadでプロダクト開発を行いながら、Chapter活動として技術的な改善や基盤整備にも取り組んでいます。

  • Frontend Chapter:フロントエンド領域を横断し、プロダクトの品質向上、パフォーマンス改善、計画的なバージョンアップやリファクタリングなどを担当
  • モバイルアプリ Chapter:iOS・Androidアプリ開発を担当。各Domainの企画段階から参加し、アプリ領域の開発を横断的にリード
  • QA Chapter:サービス品質の維持・改善をミッションに、上流工程からプロジェクトに参加。自動テストの導入や本番不具合の分析・対策など、横断的な品質向上を推進

事業やプロダクトに向き合うDomain/Squadでの活動と並行して、専門領域を軸とした技術改善にも取り組めることが、Chapterを設けている特徴です。

プロダクト開発を支えるチーム

Domain/Squadでのプロダクト開発を、技術や開発環境の面から横断的に支えるチームもあります。

Application Platform、AI Technology、Infra、DX、DevRelの5つのチームが、それぞれの専門性を活かしながら、ソフトウェア基盤の改善や開発環境の整備、組織づくりなどに取り組んでいます。
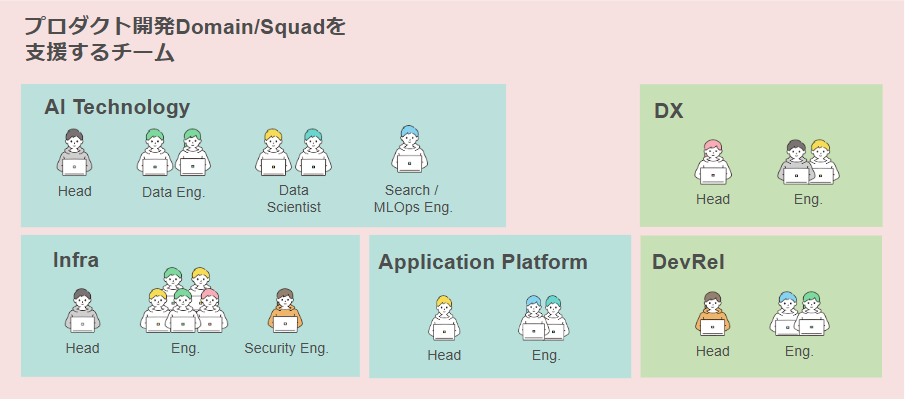
Application Platform 各Squadに共通する技術的な課題や、Squad単独では対応しづらい課題を横断的に解決し、開発全体の生産性を高めることをミッションとしています。 具体的には、言語・ライブラリ・フレームワークのバージョンアップ、AWS化に向けたアプリケーション修正、疎結合化・モジュラー化・マイクロサービス化などのアーキテクチャのモダナイズ、サービスの信頼性強化(SRE活動)などに取り組んでいます。 複数のSquadに関わる中長期的な技術課題やアーキテクチャ改善に取り組めることも、このチームの特徴です。

AI Technology AI・データ基盤・機械学習・検索など、データ領域の専門知識が必要となるシステムについて、設計・開発から運用までを担当しています。 データサイエンティスト、検索・MLOpsエンジニア、データエンジニアなどのスペシャリストが所属し、開発初期の設計・開発フェーズからSquadと密接に連携してプロジェクトを進めています。 専門性を活かしながら、AI・データ技術を実際のプロダクト開発につなげていけることも、このチームの特徴です。

Infra インフラ・セキュリティ領域の専門知識が必要となるシステムについて、設計・構築から運用・監視までを担当しています。 BUYMAのオンプレミス環境からAWSへの移行後の運用や、Kubernetesクラスタの構築・運用および開発支援、サービスのセキュリティ強化などに取り組んでいます。

※以下2つのチームは、専任メンバーでのチーム組成ではなく、他チームのエンジニアが開発業務を兼任して活動しています。プロダクト開発だけでなく、自分たちの手で「開発者体験」や「エンジニア組織の文化」を作っていけるのがエニグモの特徴です。

DX Developer Experience(開発者体験)の略で、開発者体験の維持・向上をミッションとしています。 主にBUYMAのローカル開発環境やCI/CDツールの整備などに取り組んでいます。

DevRel Developer Relationsの略で、社内エンジニアの技術力向上や知識共有、交流促進を目的として、社内LT・勉強会を企画・運営しています。 また、テックブログや対外イベント、カンファレンス協賛などを通じた技術広報にも取り組んでいます。

エンジニア組織の意思決定

ここまで、プロダクト開発を担うチームと、それを支えるチームについて紹介してきました。 複数のチームが連携してプロダクト開発を進めるSE本部では、すべての意思決定を一か所に集約するのではなく、チームを横断して情報共有や組織課題について議論する場を設けています。
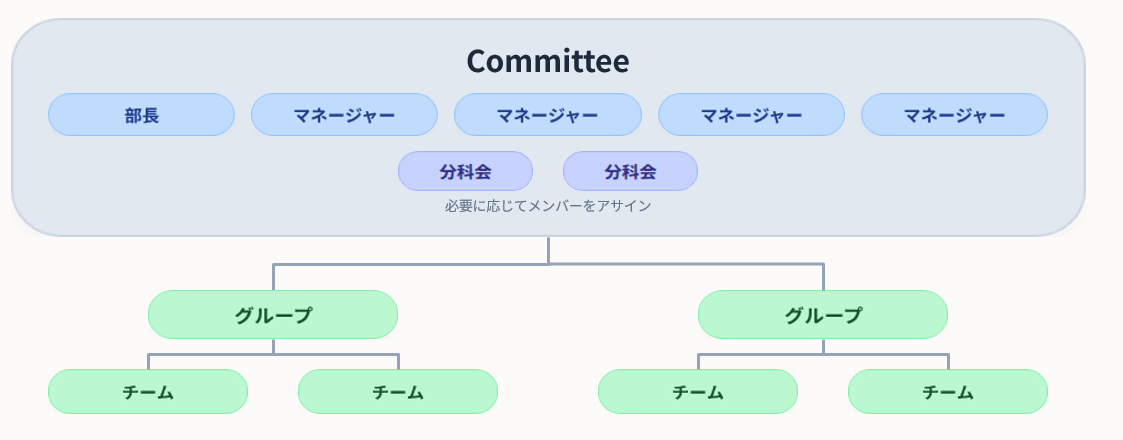
■ Committee

SE本部における組織運営や意思決定を担っています。 すべての意思決定を部長一人に集約するのではなく、内容に応じて部長が判断するもの、マネージャーを含めて議論・判断するものを分けながら意思決定を行っています。 また、特定のテーマについては分科会を設け、その領域を担当するエンジニアも議論に参加しています。

役職者だけで組織や技術に関する議論を完結させるのではなく、テーマに応じて現場のエンジニアも意思決定に関われることが、SE本部の組織運営の特徴です。

■ Squad Weekly

各SquadやChapterの状況共有や、チームを横断するアジェンダについて相談するSE本部の定例ミーティングです。

部内での情報共有や、各チームから上がってきた課題について相談・解決することを目的としています。 必要に応じて、本定例で扱われた内容を部長から役員や他部門長へ共有しています。 チーム単独では解決しづらい課題も、組織全体で素早くフォローアップできる透明性の高い環境を作っています。

エニグモならではの開発環境の魅力

ここまで、SE本部の組織・開発体制について紹介してきました。 エニグモではAIを活用した開発を進めるとともに、特定の技術領域や所属チームにとらわれず、一人ひとりのエンジニアがカバーする領域を広げていくことを目指しています。 ここでは、エニグモが目指すエンジニア像と、実際にどのような挑戦の機会があるのかをご紹介します。

■ 大規模なグローバルCtoCサービスを開発できる

BUYMAは20年以上にわたり運営を続け、1200万超えのユーザーを抱える、グローバル×CtoCの大規模プラットフォームサービスです。 多くのユーザーが利用するサービスだからこそ、安定したサービス運営を続けながら、新たな機能開発や改善を進めていく必要があります。 また、ユーザー数が多いため、施策の効果が数値として現れやすいことも特徴です。 新機能のリリース後には、A/Bテストやデータ分析を通じて成果を検証し、次の改善につなげています。 トラフィック量や扱うデータも大きく、スケーラビリティやパフォーマンスなど、大規模サービスならではの技術課題にも向き合いながら開発を進めています。 長く続くサービスを安定して運営しながら、ユーザーの反応やデータをもとにプロダクトを改善し続ける。こうした開発に携われることも、エンジニアとしての醍醐味です。

■ AI駆動開発を前提に、フルスタック・フルサイクルへ

SE本部では、AIを開発プロセスに取り入れ、AIを活用することを前提とした開発を進めています。 AIの支援によって技術領域を越えて知識を得たり、これまで専門外だった領域の開発に取り組んだりしやすくなったことで、エンジニア一人ひとりがカバーする領域を広げる「知識のフルスタック化」を目指しています。

実際に、バックエンドを主な専門領域としてきたエンジニアがフロントエンドの開発を担当するなど、これまでの専門領域に閉じずに開発を進めるケースも生まれています。 今後は技術領域だけでなく、企画から設計、開発、運用まで、個人やチームがより広い範囲でプロダクトに関わるフルスタック・フルサイクルな開発を進めていきます。 目指しているのは、AIを活用しながら自身の専門性を広げ、単独でもユーザーへの価値提供を進められる「PM兼アーキテクト」として振る舞えるエンジニアを増やしていくことです。

▼AI駆動開発については、以下の記事で詳しく紹介しています。 「AI駆動開発とベンチャー回帰で創る次世代エンジニア組織」

■ チームや事業を越えて、経験の幅を広げる

SE本部では、所属するDomainやチームを固定的なものとはしていません。 組織の状況や本人の希望などに応じて、別のDomainやチームへ異動するケースもあります。

例えば、AI Technologyからアプリケーション開発に関わるチームへ異動したり、アプリケーション開発からApplication Platformへ活動の幅を広げたりするなど、これまでの経験を活かしながら新たな領域に挑戦する機会があります。

また、通常の開発業務と並行して、DXやDevRelの活動を兼務することもできます。 プロダクト開発だけでなく、開発者体験の向上、社内の技術力向上・知識共有、社外への技術発信など、自身の関心に応じてエンジニア組織づくりにも関わることができます。

さらに、BUYMAだけでなく、新規事業やグループ会社のサービス開発にプロジェクトベースで携わるケースもあります。

BUYMA TRAVELをはじめとするグループ会社のサービスや、新規事業のサービス開発・基盤構築を担当するなど、BUYMAにとどまらず、エニグモグループのさまざまなサービス・技術領域に関わる機会があります。

まとめ

今回は、2026年現在のエニグモのエンジニア組織・開発体制についてご紹介しました。

Domain/Squadを中心としたプロダクト開発、専門領域を横断するChapter、そして開発を支える各チームが、それぞれの役割を持ちながら連携して開発を進めています。

また、AI駆動開発を前提に、これまでの専門領域にとらわれずフルスタック・フルサイクルにカバー範囲を広げたり、チームを越えた兼務や異動、新規事業・グループ会社のプロジェクトに携わったりと、エンジニアとしてさまざまな領域に挑戦できる環境があります。

エニグモでは、一人ひとりのエンジニアが自身の専門性を活かしながら、新しい技術や領域にも挑戦し、プロダクトや事業への価値提供の幅を広げていくことを目指しています。

そんなエニグモの開発組織に少しでも興味を持っていただけた方は、ぜひ私たちと一緒に、これからのプロダクトや開発組織をつくっていきませんか?
【無停止移行】Ingress-NGINXからNGINX Gateway Fabricへ無停止で移行する

こんにちは。インフラグループ Kubernetesチームのmendです!

私たちのチームでは、マイクロサービスの実行環境として、AWS上のKubernetes(EKS)を活用しています。 現在、長年クラスタの入口として活躍してくれた「Ingress-NGINX」がEOLとなりましたので、次世代規格であるGateway APIに準拠した 「NGINX Gateway Fabric」 への移行を行いました。

今回は、移行を決めた背景から、 AWS Load Balancer Controller + external-dns を組み合わせた既存構成の解説、そして 「加重ターゲットグループを活用した本番無停止の切り替え設計」 についてお話しします!


1. 背景: なぜ今、Ingress-NGINXからの移行なのか

事の発端は、これまでKubernetesコミュニティでデファクトスタンダードとして使われてきた ingress-nginx プロジェクトがすでに EOL(End of Life)を迎えたこと でした。

現在、Ingress-NGINX は セキュリティパッチの提供を含むすべての更新・保守が停止しています。 そのため脆弱性が発見されても修正されないものを抱え続けることは、セキュリティ観点から非常に大きなリスクとなります。

こうした事態を受け、移行先の調査を行った結果として、Ingressを発展させた機能であるGateway APIへの移行と、 Gateway ControllerとしてNGINX Gateway Fabricを選定しました。


2. 既存構成: Ingress、Ingress-NGINX、およびAWS連携

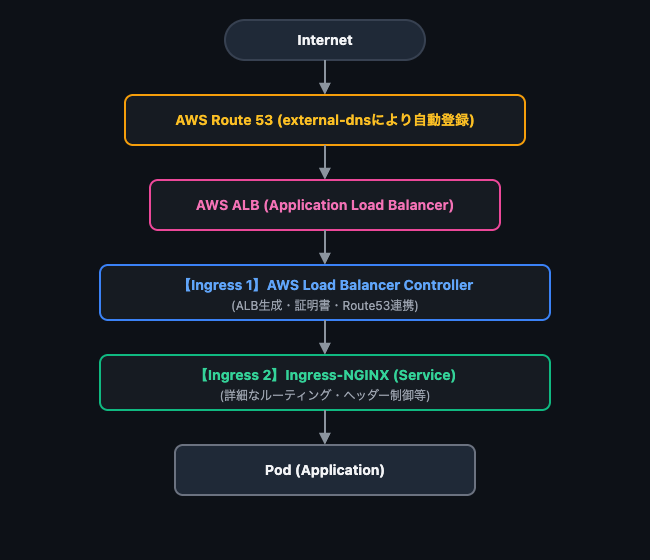
私たちの現在の環境では、単に Ingress-NGINX を置くだけではなく、AWSのマネージドサービスと連携させるために 2つのIngressリソース を組み合わせた構成を採用しています。

既存構成

  1. Ingress 1(AWS Load Balancer Controller用)
    AWS上にALBを設置するためのものです。また、external-dns も組み合わせることで、このIngressに設定したホスト名をトリガーに AWS Route 53 へAレコード/ALIASレコードを自動登録させています。トラフィックはここから Ingress-NGINX の Service へ渡しています。
  2. Ingress 2(Ingress-NGINX制御用)
    Ingress-NGINX自体の挙動や、Webアプリケーションに必要な詳細なルーティングルール(アノテーションを用いたヘッダー操作やアクセス制限など)を定義しています。

既存構成の課題

この構成はAWS連携と柔軟な通信制御を両立できる反面、Ingressリソースのアノテーションに大量の設定が記載されて管理しにくくなり、既にEOLとなった Ingress-NGINX 固有のアノテーションに依存しているという課題がありました。


3. 次世代規格「Gateway API」とは

こうしたIngressの課題を解消するためにKubernetesコミュニティによって設計されたのが Gateway API です。

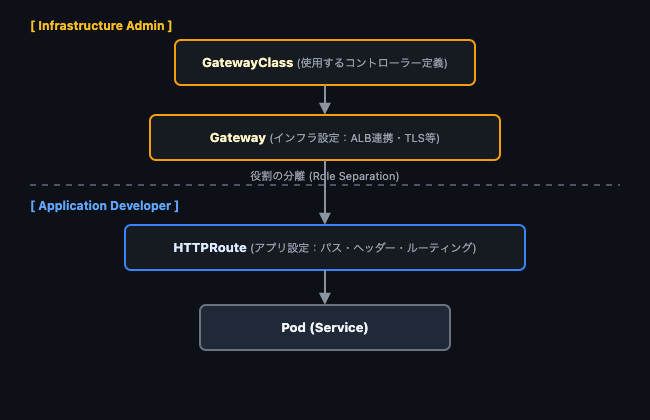
Gateway APIのリソースと構造

Gateway APIの最大の魅力は 「役割の分離(Role-Oriented)」 と 「標準化」 です。 インフラ側が設定する Gateway と、アプリ開発者が設定する HTTPRoute にリソースが分かれており、アノテーション地獄に頼らず標準Specで柔軟なルーティングを表現できるようになります。
またIngressに関しては、今後は機能の拡張は基本的に行われず、Gatewayの利用を推奨しています。
すぐにIngressの機能が削除されるということは無いようですが、将来的には Gateway での実装が主流になると思われます。

kubernetes.io

Note:
The Kubernetes project recommends using Gateway instead of Ingress. The Ingress API has been frozen.
This means that:

  • The Ingress API is generally available, and is subject to the stability guarantees for generally available APIs. The Kubernetes project has no plans to remove Ingress from Kubernetes.
  • The Ingress API is no longer being developed, and will have no further changes or updates made to it.

例: IngressリソースをGateway APIの形式に書き換える

Ingressで構築していたアクセス経路をGateway APIの形式に書き換えるにあたり、manifestの内容は大きく変わります。
例として、以下のようなIngress-NGINXのRateLimit機能のアノテーションが含まれるIngressリソースがあるとします。

apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  annotations:
    kubernetes.io/ingress.class: ingress-nginx
    nginx.ingress.kubernetes.io/limit-rps: "20"
  name: service-a-ingress
  namespace: example
spec:
  ingressClassName: ingress-nginx
  rules:
  - host: ingress-test.example.com
    http:
      paths:
      - backend:
          service:
            name: service-a
            port:
              number: 80
        pathType: ImplementationSpecific

このIngressをGateway APIのリソースの形に書き換えると、以下のようになります。 まずは Gateway リソースです。

apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: nginx-gateway
  namespace: gateways
spec:
  gatewayClassName: nginx
  listeners:
  - allowedRoutes:
      namespaces:
        from: All
    name: http
    port: 80
    protocol: HTTP

このように書き換える必要があります。
Gatewayリソースのspec.listenersには、どのプロトコル・ポートでアクセスを受け付けるか、別のnamespaceのHTTPRouteへのトラフィックを許可するかなどを記載します。
Ingressとは異なりserviceへの通信経路の設定は記載しません。

続いてHTTPRouteです。
HTTPRouteはGatewayからのトラフィックをserviceに渡す設定を主に記載します。
先ほどのnginx-gatewayのGatewayリソースからのトラフィックをservice-aに渡す設定は、このようになります。

apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: service-a-httproute
  namespace: service-a
spec:
  hostnames:
  - ingress-test.example.com
  parentRefs:
  - name: nginx-gateway
    namespace: gateways
    sectionName: http
  rules:
  - backendRefs:
    - name: service-a
      port: 80
    matches:
    - path:
        type: PathPrefix
        value: /

spec.hostnamesには通信を受け付ける際のhost名を記載します。
spec.parentRefsには通信を受け取る元のGatewayを指定します。
そしてspec.rulesには通信を渡すserviceを指定し、Podへのアクセス経路が確立されます。
IngressのpathType: ImplementationSpecificとして記載されていたものは、このHTTPRouteのtype: pathPrefixが対応する挙動になります。
では Ingressのアノテーションにあった nginx.ingress.kubernetes.io/limit-rps: "20"のRateLimitの設定は、どのように HTTPRouteで再現するのでしょうか。

結果としては、RateLimit機能をHTTPRouteに設定するために、例としてNGINX Gateway FabricではRateLimitPolicyが必要になります。
RateLimitPolicyは以下のようになります。

---
apiVersion: gateway.nginx.org/v1alpha1
kind: RateLimitPolicy
metadata:
  name: rate-limit-policy
  namespace: service-a
spec:
  targetRefs:
  - group: gateway.networking.k8s.io
    kind: HTTPRoute
    name: service-a-httproute
  rateLimit:
    local:
      rules:
      - zoneSize: 5m
        rate: 20r/s
    logLevel: "warn"
    rejectCode: 429

このようにRateLimitPolicyを作成し、spec.targetRefsに紐づけるHTTPRouteを記載することでRateLimit機能を使用できるようになります。
またこのRateLimitPolicyリソースはNGINX Gateway Fabric上でRateLimit機能を使うためのリソースです。
NGINX Gateway Fabric以外を使用する場合は異なるため、詳しくはGateway Controllerの公式ドキュメントを参考に実装しましょう。

公式によるツールでの変換

Kubernetesの公式からIngress2Gatewayというツールがリリースされています。
こちらのツールは、クラスタ上のIngressリソースをGateway APIに変換するツールとなっております。
このツールを使うことで、簡単にIngressリソースをGateway、HTTPRouteのリソースに変換することができます。
しかし注意すべき点として、Ingressのアノテーションに設定していたnginx.ingress.kubernetes.io/limit-rps: "20"のようなIngress Controllerの固有の設定があります。
Ingress Controllerの固有の設定は、全て直接Gateway APIのリソースに変換できるものではありません。
この部分はIngress ControllerとGateway Controllerのドキュメントを見て、手作業で実装を変換する必要がありますので、気をつけてください。


4. NGINX Gateway Fabric とは

Gateway APIを実装するコントローラーの中で、私たちが選んだのが NGINX Gateway Fabric です。

選定理由

  • NGINXの高い信頼性: 長年本番環境で運用し、パフォーマンスや挙動の特性を熟知しているNGINXがデータプレーンとして使われている安心感。
  • F5 / NGINX公式による手厚い開発: EOLとなった Ingress-NGINX と異なり、開発元である NGINX 社が主導して Gateway API 仕様に準拠させているため、将来にわたる積極的な開発とセキュリティパッチの提供が約束されている点。
  • AWS環境との相性の良さ: AWS Load Balancer Controller や external-dns との組み合わせにおいても、構造をシンプルに整理できる見込みが立ったこと。

5. 無停止で切り替える移行計画(加重ターゲットグループによる安全なアプローチ)

現在は移行が完了し、「本番トラフィックを落とさずに、2段構えのIngress構成から NGINX Gateway Fabric へどう切り替えるか」 の課題をクリアすることができました。

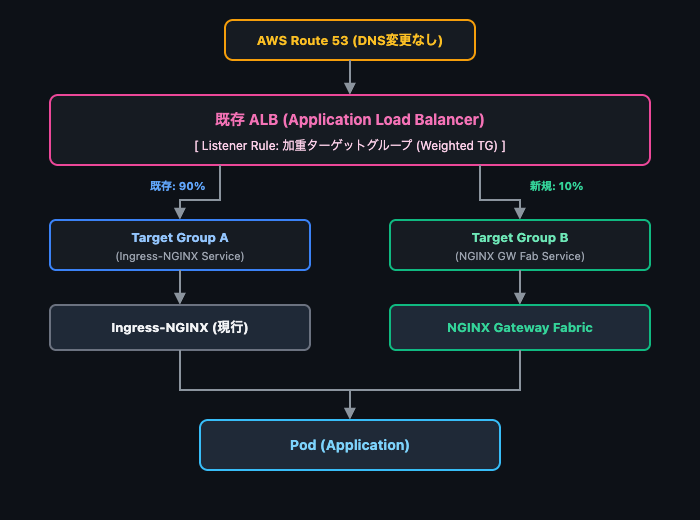
切り替えには、同一ALB内で割り当て先を制御できるALBの加重ターゲットグループ(Weighted Target Groups)機能を活用します。DNSの切り替えを待つことなく、 ALBのレイヤーで即座にパーセンテージ制御が行えるのが最大のメリットです。

加重ターゲットグループを活用した段階的移行

移行フロー

STEP 1: データプレーン(Service)レベルでの事前検証とターゲットグループ準備

既存の Ingress や ALB には一切手を加えず、クラスタ内に NGINX Gateway Fabric リソース群をデプロイします。

ALB側にテスト用パスをわざわざ作成するようなことはせず、NGINX Gateway Fabric によって生成されたデータプレーン(Pod)の前段に配置される Kubernetes Service に対して直接アクセス(kubectl port-forward やクラスタ内の検証用Podからのダミーリクエスト等)を行い、HTTPRoute の定義通りにバックエンド Pod へ正しくトラフィックが到達するかを事前に検証します。

疎通とルーティング動作が確認できたら、その Service を紐づける新しいAWSターゲットグループ(Target Group B)を作成・準備します。

STEP 2: ALBリスナールールへの「加重ターゲットグループ」設定

準備が整ったら、本番トラフィックを受けるALBのリスナールールを「単一ターゲットグループへの転送」から「加重ターゲットグループ(Weighted Target Groups)」へ変更します。

  1. 既存 Target Group A (Ingress-NGINX Service) : 99
  2. 新規 Target Group B (NGINX Gateway Fabric Service) : 1

最初は 1% のトラフィックのみを NGINX Gateway Fabric 側へルーティングします。

STEP 3: 段階的な移行

Datadog や CloudWatch、アクセスログをリアルタイムで監視しながら、問題がないことを確認しつつ重み付け比率を引き上げていきます。
例として、以下のような比率で段階的に切り替えが可能です。

  • 99 : 1 ── 疎通・初期エラーの確認
  • 90 : 10 ── 一部ユーザー環境での挙動とリソース使用率の観測
  • 50 : 50 ── 負荷分散状態の確認
  • 0 : 100 ── 全トラフィックの移行完了
加重ターゲットグループを採用した理由

DNSレコードの変更(Route 53)による切り替えでは、クライアント側のキャッシュやTTLの影響で切り替え完了までに時間がかかります。
ALBの加重ターゲットグループであれば、マネジメントコンソールやAPIからの操作で数秒レベルでトラフィック比率を変更・即時全量ロールバックできるため、本番運用上のリスクを劇的に下げることができます。

STEP 4: 旧構成の撤去

全トラフィック(100%)が Target Group B(NGINX Gateway Fabric)経由で安定稼働していることを一定期間確認したのち、旧ターゲットグループ(Target Group A)および不要になった Ingress 2(Ingress-NGINX設定)を削除して移行完了となります。


6. 移行時の注意点

移行を行ううえで、以下の注意すべき点が見られましたので、こちらでまとめます。
移行時にはこれらに注意して移行・実装を行ってください。

注1 AWS Load Balancer Controller の Ingress と Service の namespaceについて

AWS Load Balancer ControllerをIngress ControllerとしているIngressでは、加重ターゲットグループの機能でIngress-NGINX側とNGINX Gateway Fabric側のターゲットグループとして、それぞれServiceを設定することでアクセスの振り分けを定義していました。
しかし加重ターゲットグループで指定するServiceにはIngressの仕様上、別のnamespaceのServiceを指定できないようになっています。
そのため本記事と同じ方法で加重ターゲットグループの設定を行う場合、NGINX Gateway FabricのData PlaneのServiceは同一namespaceに作成する必要があるため注意してください。

注2 ServiceのTypeについて

もともとKubernetesでは別のnamespaceのserviceをingressに紐づけることはできない仕様になっております。
そしてこの仕様の回避するため、externalNameのServiceを利用する手法があります。 今回の移行でも、当初は AWS Load Balancer Controller (ALB)のIngressに対し、
加重ターゲットグループのターゲットとして別のnamespaceに存在する NGINX Gateway Fabric のServiceを externalName で作成して指定しました。 しかし結果としては、この手法ではALBの加重ターゲットグループのターゲットとして登録ができず、この構成では正しく機能することはありませんでした。 ここで原因調査のためAWS Load Balancer Controllerの公式ドキュメントを確認したところ、target-type: ipの場合の挙動が原因でした。 AWS Load Balancer Controllerが target-type: ip で動作する際、コントローラーは指定されたServiceの「Endpoints(PodのIP)」を取得してALBのターゲットに登録しようとします。
しかしExternalName タイプのServiceはCNAMEを返すのみでEndpointsを持ちません。 そのためPodのIPアドレスを解決・ターゲット登録することができず、ALBからのトラフィックを流すことができないことが問題の原因でした。 つまり、AWS Load Balancer ControllerのIngressに紐づけるServiceのTypeにはexternalNameのService を指定できない という点に注意してください。


7. まとめ

今回は AWS Load Balancer Controller と連携した既存の2段Ingress構成を、加重ターゲットグループを活用して安全に NGINX Gateway Fabric への移行 を行いました。

移行を通じて得られた手応え

  • セキュリティと保守性の確保: EOLを迎えた Ingress-NGINX から脱却し、公式サポートが継続する安全な基盤へ移行できる。
  • 設定のシンプル化: 複雑化していた独自アノテーションから脱却し、Gateway API 標準の構成へ整理できた。
  • 安全な切り替え設計: クラスタ内での事前検証からALB加重ターゲットグループによる制御まで、DNS遅延の影響を受けず即座に制御・即座にロールバックが可能な本番運用設計が完成した。

Kubernetesも登場から時間が経ち、リリース当初からの古いシステムが徐々に新しいシステムに更新されていくと思います。
このような大きな変更の際にも、安定的な対応ができるように運用を進めていきたいと思います。

ユーザーにいち早く価値を届けるために、何を先に作り、何を後から取りに行くか ― 買取保証を3フェーズで作った話

こんにちは。BUYMA で購入者向け機能を開発している Web エンジニアの高橋です。所属している BUY チームは、BUYMA の購入者側の体験(集客と CVR)を担当しています。

2025年末、BUYMA は対象商品の購入時に将来の買取金額を提示するサービス「買取保証」を開始しました。保証期間内に申し込めば、購入代金の一部が現金または BUYMA ポイントで戻る仕組みです。

プロダクトとしてはシンプルですが、この機能はフェーズを分けて段階的に作ってきました。進め方として意識していたのは、要件を全てこなすのではなく、自分たちで課題を見つけ、いち早くユーザーに価値を届けるための落としどころを見つけて、スピーディに意思決定してリリースすることです。完全な設計を一度に作るより、今回どこまでを作ってどこを後回しにするかを自分たちで決める、という進め方です。

この記事では、それをどう作ってきたかを振り返ります。

フェーズ

フェーズ 目的
フェーズ1 買取保証つきで購入できる状態を作る
フェーズ2 スナップショットを3段に作り直す
フェーズ3 保証期間内に申し込めるようにする

フェーズ1 — セール前必達という制約

最初のリリースには、大きなセールの開始日という外部的な期日がありました。そこでスコープをこう切ります。

  • 条件マスターを用意する
  • 商品詳細で「買取保証対象」を表示する
  • 購入確定時に、取引と同じトランザクションで保証レコードを作る

そして、カート段階でのスナップショットは作らないと決めました。カート周辺の実装は歴史的に複雑で、ここに手を入れると期日に間に合わないと判断したためです。

省略しても機能自体は成立します。購入確定時に判定すれば保証レコードは作られ、ユーザーは買取保証つきで購入できます。 動かせない期日に対して、「保証が付く」ことを優先し、「提示した条件のまま付く」ことを次フェーズに回したという判断です。

条件マスターを YAML で持つ

買取対象は「このブランドのこのカテゴリなら、現金○%、ポイント○%、申請期限は○日」といったルールの集合です。これを設定ファイル(YAML)に置き、起動時にメモリへ載せています。

module Buyback
  class BuybackCondition
    ATTRIBUTES = %i(
      id brand_ids cate_ids model_ids exclude_model_ids size_ids color_ids
      cash_price_rate point_price_rate upper_limit_price request_period_days enabled
    ).freeze
    # ...
  end
end

YAML にしたのは、管理画面やテーブル設計より「レビュー可能な設定ファイル」の方が速かったからです。クラスコメントには、将来 ActiveRecord へ移す前提だと書いておきました。

ただし、そのテーブル化を見越して次の2点は最初からルール化しています。

  • 不要になった条件は削除せず enabled: false にする(論理削除)
  • 一度本番に出した条件 ID は変更しない

「この保証はどの条件によって付与されたのか」を後から追跡できないと、問い合わせ対応も効果測定もできなくなるからです。保証レコードには条件 ID を持たせています。

スナップショットを省略すると何が壊れるか

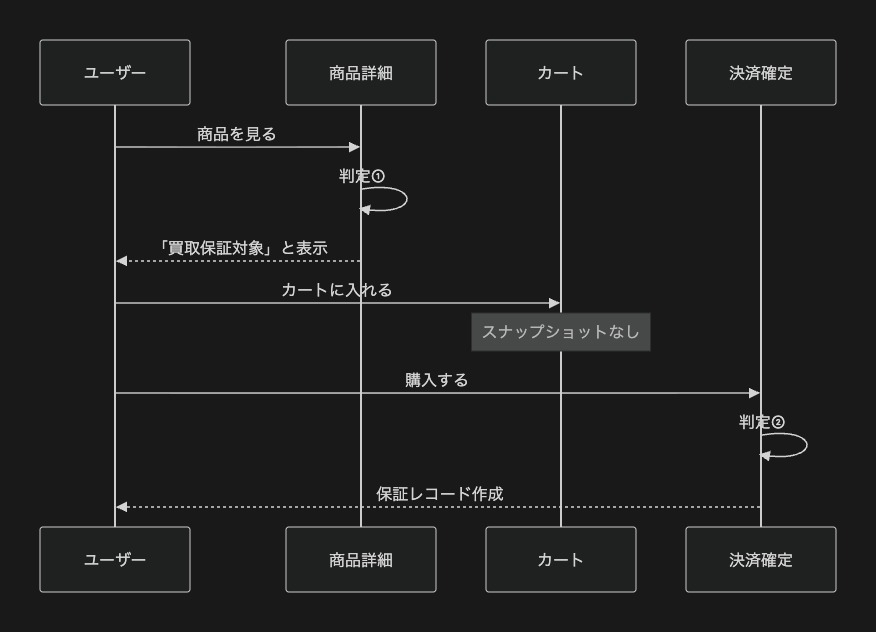
カートを飛ばした結果、買取条件の判定タイミングが商品詳細と決済確定の2回に分かれました。

判定が2回あると、あいだにユーザーの選択が入ります。そこで問題になったのが、上限金額と配送料の関係です。

BUYMA の商品は、同じ商品でも購入者が選んだ配送方法で最終金額が変わります。買取保証の対象判定には上限金額があるので、送料を見ずに判定するとこうなります。上限を 50,000 円、商品を 48,000 円としてみます。

タイミング 判定
商品詳細(本体 48,000 円だけで判定) ✅ 対象として表示
カートで高い元払い配送(3,000 円)を選択 —
決済確定(51,000 円で上限超過) ❌ 対象外

買取保証があるから買おうとしたのに、買ったとたんに保証が付いていない。商品ページの表記を信じたユーザーが、送料込みの本番判定で外れるパターンです。

対応は、商品詳細での判定単価を最初から厳しくすることでした。

詳細の判定単価 = 商品本体 + 元払い送料の最大値

# 商品詳細キャッシュから判定する場合
def adjusted_tanka
  base_price = item_detail[:spec_price] || item_detail[:tanka]
  base_price.to_i + highest_shipping_price
end

def highest_shipping_price
  prepaid_methods = (item_detail[:shipping_methods] || []).select do |method|
    method[:payment_type] == MShippingMethod::PaymentType::PRE_PAID
  end
  return 0 if prepaid_methods.blank?

  prepaid_methods.map { |method| method[:shipping_price].to_i }.max
end

元払いの最高額が 3,000 円なら、詳細は 51,000 円として判定され、最初から買取保証の表示を出しません。安い送料(1,000 円)を選んだときだけ、購入時の最終判定で対象になります。

送料を足さない詳細 最高元払いを足す詳細(今の仕様)
詳細の表示 対象と出る 非対象(買取保証の表示なし)
高い送料を選んだとき カートで保証が消える もともと出ていない
安い送料を選んだとき 対象のまま ここで初めて付く

防ぐ向きは「対象 → 対象外」、残す向きは「対象外 → 対象」です。着払いを足さないのは、詳細では着払い送料を商品代金に上乗せしないと見ているからで、見るのは元払いの最大だけです。

判断基準:差分をゼロにすることを目指すのではなく、どちら向きの差分なら許容できるかを考える。ユーザーに不利益が出る差分は防ぎ、ユーザーに有利な差分は許容する。

色・サイズも同じ発想で、商品の持つ値がすべて条件に含まれているときだけ対象として表示します。 対象商品数は減りますが、「対象と表示されていたのに、選んだ色が対象外だった」よりは良いという合意を事業側と取りました。

def match_size_ids?(condition)
  return true if condition.size_ids.blank?
  return false if product_attributes[:size_ids].blank?

  (product_attributes[:size_ids] - condition.size_ids).empty?
end

詳細ではその商品の全バリエーション、カートでは選んだ1行だけを見ます。条件が M のみで商品が S / M / L なら、詳細では非対象、カートで M を選ぶと対象です。

フェーズ2 — スナップショットを3段に作り直す

フェーズ2でやったのは、省略したスナップショットを入れることです。

テーブル 役割
D_CART_BUYBACK_GUARANTEES カート中の作業用スナップショット
D_FIXED_CART_BUYBACK_GUARANTEES 決済直前の確定スナップショット
D_BUYBACK_GUARANTEES 取引に紐づく保証の正本

カートや確定カートはクリーンアップ対象です。保証の正本は取引寿命に合わせて残します。

最大の成果は、決済確定時の再判定を撤去できたことです。決済確定は確定スナップショットを読んで保証レコードを作るだけになり、非同期決済のタイムラグ問題が消えました。

保存するのは料率であって金額ではない

カート保証に保存するのは条件 ID と料率・申請日数です。買取金額そのものは持ちません。金額は「単価 × 料率」で都度計算します。クーポンや数量で表示単価が変わっても、料率側の約束を壊さないためです。

また、カート投入時の判定結果を「正」にしないとも決めました。カートは長く残り、その間に条件マスターが変わり得るからです。カート表示時・カート操作時・購入手続き時に再判定します。

差分を「エラー」でなく「再同意を取る状態」にした

再判定すると当然、前回の結果と差分が出ます。バリデーションは3種類です。

エラー 意味
buyback_guarantee_unavailable カート投入時は対象だったが、今は対象外
buyback_guarantee_newly_available 投入時は対象外だったが、今は対象
buyback_guarantee_mismatch 対象のまま、条件 ID や料率・日数が変わった

「今は対象になった」もエラーにしているのは、ユーザー同意なしに保証を足さないためです。フロントは再判定後の条件を受け取り、ユーザーが確認したうえでカートを更新します。つまりエラーレスポンスは失敗の通知ではなく、同意を取り直すための状態遷移です。

依存関係付きのバリデーション基盤に載せているので、購入不可商品の判定が落ちたあとに買取保証だけを見に行く、といった無駄も避けています。

決済では確定カートを行ロックして焼き付ける

購入処理に入ると、カート保証は確定カート保証へコピーされます。その後、取引作成時に Buyback::GuaranteeCreator が本命の D_BUYBACK_GUARANTEES を作ります。

ここで初めて現金・ポイントの買取額を整数で確定します。期限は「注文日時 + 申請日数」の当日終わりです。

決済処理中に同じ確定カート保証を並行して処理しないよう、参照時に行ロックを取得しています。これはクーポンやタイムセールでも使っている既存の排他制御パターンを踏襲しています。

フェーズ3 — 申込み

フェーズ3は「保証を作る」側から「保証を使う」側へ移る回でした。ここで初めて、システムの外側——現物の買取オペレーションと接続する必要が出てきます。

ここからの課題は、Web上で保証を正しく扱うことではなく、保証を既存の買取オペレーションへ安全につなぐことでした。

画面は相乗りさせ、申請フローは分離する

実装
表示 既存の /my/vintage/offer に、買取保証対象の別セクションを追加
申請 同じエンドポイント。中古買取と買取保証で updater を分ける

買取申込みの置き場所には、既存の「中古アイテム買取」がありました。マイページから手持ちの商品の買取を申し込む機能で、運用の受け口もすでに動いています。

そこで、表示は既存画面に相乗りさせ、保存処理は種別で分けるという切り方をしました。 エンドポイントは同じ /my/vintage/offer(new / confirm / create / complete)です。画面上は別セクションを足し、保存時は source_type で updater を切り替えます。

{
  vintage: ::My::VintageOffer::VintageRequestUpdater,
  buyback: ::My::VintageOffer::BuybackRequestUpdater
}[resolve_type]

ユーザーからは「同じページに2つの申込み枠がある」ように見えますが、内部では別物です。分けた理由は3つあります。

  • 表示ロジックと申請ロジックの責務を分けられる
  • 二重申請の防止や状態遷移といった、保証固有のバリデーションを保証側だけで完結できる
  • 参照する DB が違う(中古買取は MySQL、買取保証は SQL Server)ので、その影響範囲を局所化できる

3つめは特に実務的な理由です。既存の申込み画面は MySQL 側のテーブルから中古買取候補を引いていますが、買取保証のデータは SQL Server 側にあります。 現在の構成では MySQL と SQL Server をまたいだ JOIN を前提にできないため、コントローラで2本の別クエリを投げ、取引 ID でハッシュ化してビューに渡し、別パーシャルとして描画しています。「1つの画面だから1つのクエリにまとめたい」という発想を捨てたほうが、既存フローへの影響がゼロになりました。

そして、中古買取申請と買取保証申請は同時には行えない排他として扱っています。

個品IDという共通言語を後から作る

申込みを受けたあとは、実物の集荷・査定・入金が走ります。この運用は管理アプリで回っているので、買取保証の申請を既存の運用フローに乗せなければなりません。

ここで問題になったのが、管理アプリが「個品ID」として中古買取のアイテムIDをそのまま使っていたことです。中古買取のテーブルの主キーが、そのまま運用上の識別子になっていました。買取保証のアイテムは別テーブルにあるので、このままでは管理アプリに載りません。

選択肢は2つありました。

  1. 管理アプリ側で「中古買取由来か、買取保証由来か」を区別しながら2系統のIDを扱う
  2. 両方を束ねる個品IDテーブルを新設し、そこの ID を正とする

採ったのは2です。運用側に「このIDはどっちの由来か」を意識させたくなかったからです。個品IDテーブルを作り、中古買取由来なら中古買取のアイテムID、買取保証由来なら保証ID——どちらか片方だけを持つ形にしました。

ユーザーに見える申請は排他にしつつ、現物を扱う運用側は同じ識別子体系に寄せる。この非対称な線引きが、結果的に両方の修正コストを下げました。

動いているIDを置き換えるための段階リリース

やっていることは「すでに運用で使われている識別子の定義を差し替える」ことなので、リリースは6段階に分けました。

リリース 内容
第1 テーブル作成とデータ連携への追加(参照のみ)
第2 過去分マイグレーションとバックフィルの本番化・実行
第3 中古買取の申請時に個品IDを自動発行
第4 管理アプリの個品ID参照元を新テーブルへ切り替え
第5 買取保証の申込みフォームを公開
第6 買取保証の申請データを管理アプリへ連携開始

工夫が要ったのは第2〜第4です。

過去分の移行では、申請済みの中古買取アイテムだけを対象に、初回のみ ID を明示指定して INSERT しました。新しい個品IDと、これまで運用で使われていた中古買取のアイテムIDを一致させるためです。こうしておくと、すでに印字済みの伝票や運用中のシート上の番号がそのまま生き続けます。移行後に採番値を最大ID+1に調整して、以降の自動採番と衝突しないようにしています。

それでも、第2リリースの移行実行と第3リリースの自動発行のあいだには、「申請は保存されるが個品IDが未作成」という期間が理論上生まれます。 ここは冪等なバックフィルスクリプトで埋める前提にしました。何度実行しても同じ結果になるので、切替の前後で走らせておけば差分は吸収されます。

判断基準: 当時の実測トラフィックを踏まえ、申請停止を伴うメンテナンスは行わないと決めた。整合性をロックで守るか、業務量を見て後追いの収束で守るかは、実測値で決める。

どこを即時整合にして、どこから収束に任せたか

ここまで出てきた判断を並べると、一律のルールでは決めていないことが分かります。

場面 選んだ方式 根拠
決済確定時の保証レコード作成 即時整合(行ロックで二重作成を防ぐ) 金額の約束そのものなので妥協できない
カート表示時の条件差分 即時整合(再判定してユーザーに再同意を求める) 提示した内容と違う保証を黙って付けられない
段階リリース中の個品ID 後追い収束(冪等バックフィル) 当時の実測トラフィックを踏まえ、後追い収束を許容できると判断

判断の分かれ目は「壊れたときに誰がどれだけ困るか」でした。金額と同意は即時に守り、運用が翌日吸収できるものは収束に任せる。この線を毎回引き直すのが、実際の設計作業のほとんどを占めていました。

これから、そして残った教訓

通して手元に残った教訓はこの2つです。

  • 許容する差分は、ユーザーにとって有利か不利かで非対称に判断する
  • 即時整合か後追いの収束かは、機能単位ではなく場面単位で引き直すもの

リリース後の効果検証では、はじめて BUYMA を利用するお客様や比較的手の届きやすい価格帯でプラスの傾向が見られ、アンケートでも「購入時の安心感につながる」という回答が半数を超えました。

買取保証は「今買う判断」を支える機能です。実装側では、その判断に使った数字を、決済と申込みの瞬間まで同じ意味で持ち続けることが仕事でした。同じような「後から条件が変わる約束」をカートに載せるとき、参考になれば幸いです。

Visual Intelligence 対応を支える画像検索基盤を作る:数千万枚の商品画像を扱うための設計と運用

こんにちは、エニグモのAIテクノロジーグループの太田です。

BUYMA では最近、Apple が iOS で提供している Visual Intelligence*1 に対応し、iPhone で見つけたアイテムや画像をきっかけに、BUYMAの商品を探しやすくする取り組みを進めています。

この仕組みに対応するには、ユーザーが見ている画像に近い商品を BUYMA の商品データの中から素早く探せる必要があります。そのために私たちは、大量の商品画像を検索可能な形に変換し、継続的に更新できる画像検索基盤を構築しました。

この記事では、Visual Intelligence 対応の裏側で、私たちがどのように画像検索基盤を設計し、運用できる形にしてきたかを紹介します。

画像検索をプロダクトに組み込むには、検索アルゴリズムだけでなく、数千万枚規模の商品画像を処理するデータ基盤、複数の機能から安全に使えるAPI設計、そして継続的に運用できるコスト設計が必要になります。

今回は、以下の観点から、BUYMA の画像検索基盤づくりを振り返ります。

数千万枚の商品画像を扱うためのデータ処理基盤

画像検索を実現するには、商品画像をあらかじめ 埋め込みベクトル(embedding) に変換しておく必要があります。

埋め込みベクトルとは、画像やテキストなどのデータを数値のベクトルとして表現したものです。類似した意味や特徴を持つデータ同士が、ベクトル空間上でも近くなるように表現されるため、画像検索や類似検索でよく使われます。

BUYMA では大量の商品画像を扱っており、検索対象となる画像は数千万枚規模になります。これを単純に1枚ずつ処理していては、処理時間が現実的ではありません。日々更新される商品データに追従するには、大量の画像を安定して処理できる仕組みが必要でした。

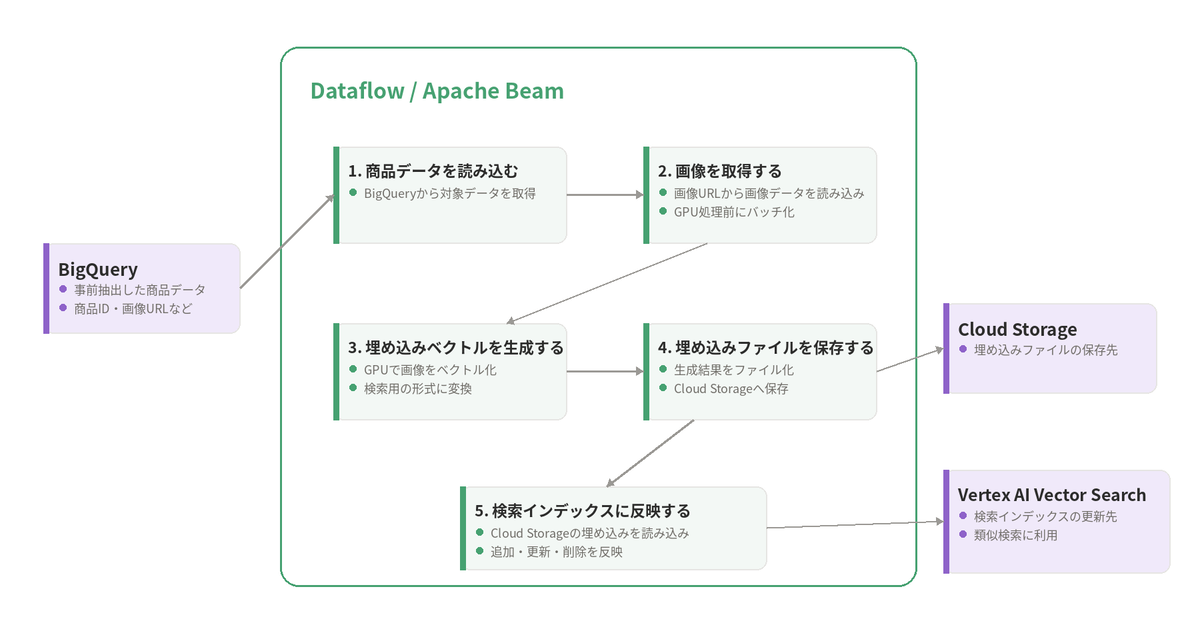
そこで私たちは、Google Cloud の Dataflow を使った分散処理基盤を構築しました。

Dataflow は、Apache Beam のパイプラインを実行できる Google Cloud のマネージドサービスです。Cloud Storage、BigQuery、Vertex AI Vector Search など、周辺の Google Cloud サービスと組み合わせやすい点も、今回の用途に合っていました。

検証では、「商品画像を取得 → モデルで埋め込みベクトルへ変換 → 検索インデックスに投入するためのデータを作成」という一連の処理を対象にしました。

処理件数、ワーカー数、処理時間、実行コストを確認しながら、次のような観点を見ています。

  • 数千万枚規模に拡張したときに、処理時間が運用上許容できるか
  • 日々の差分更新に追従できるか
  • 処理時間とコストのバランスが取れているか
  • 途中失敗時の再実行や復旧がしやすいか

この検証により、画像を一括で処理する初期構築と、日々の差分更新の両方を見据えたパイプライン設計ができました。

現在の処理は、概念的には以下のような流れです。

この基盤によって、数千万枚規模の商品画像を検索可能な形に変換し、Visual Intelligence 対応を含む画像検索機能の土台を作ることができました。

複数の機能から使いやすい API として設計する

画像検索基盤は、Visual Intelligence 対応だけに閉じたものではありません。

BUYMA の検索体験の改善や、出品支援など、画像を起点に商品を探す・提案する機能にはさまざまな応用先があります。そのため、特定の機能に密結合した実装にせず、複数の機能・用途から再利用しやすい API として設計しました。

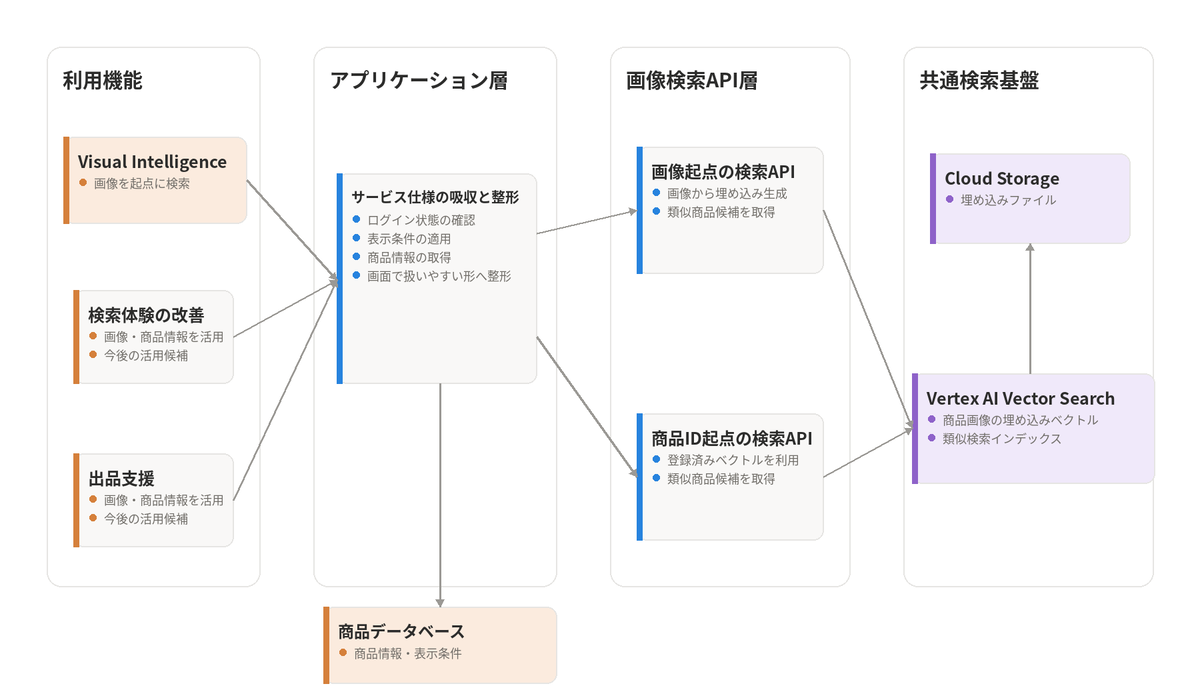
基本構成は以下の4層です。

この構成では、BUYMA のサービス仕様に関わる処理と、画像検索そのものに関わる処理を、それぞれ扱いやすい層に分けています。

たとえば、ログイン状態の確認、商品情報の取得、販売状態や表示条件の適用、画面で扱いやすいレスポンスへの整形といった処理は、BUYMAのアプリケーション側で扱うほうが自然です。

一方で、商品IDや画像を入力として受け取り、埋め込みベクトルの生成や Vertex AI Vector Search への問い合わせを行う処理は、画像検索API層に閉じ込めたほうが扱いやすくなります。

この分け方により、アプリケーション側の開発者は画像検索API層の内部実装を詳しく知らなくても、BUYMA のサービス仕様に沿った形で画像検索の結果を扱えます。また、画像検索 API 層も特定の画面や機能に依存しすぎず、共通基盤として改善しやすい状態を保てます。

この構成には、次のようなメリットがあります。

  • プロダクト側の仕様変更をアプリケーション層で吸収しやすい
  • 画像検索 API 層を、特定の画面や機能に依存しすぎない形に保ちやすい
  • 検索処理そのものの改善を、共通基盤側で進めやすい
  • 新しい利用機能が増えたときに、どちらの層で対応すべきかを考えやすい

特に今後の拡張では、アプリケーション層で吸収すべき仕様なのか、画像検索 API 層に共通機能として持たせるべき処理なのかを切り分けることが重要になります。

たとえば、画面表示の都合や BUYMA 固有の表示条件であればアプリケーション層で扱い、検索ロジックや候補生成の共通処理であれば画像検索API層で扱う、といった判断です。

この切り分けを意識しておくことで、機能追加のたびに基盤が複雑化することを防ぎながら、検索体験の改善や出品支援など、複数の用途に展開しやすい状態を保てると考えています。

検索対象範囲とコストをどう決めるか

画像検索基盤では、検索対象を広げるほど、ユーザーが見つけられる商品候補は増えます。

一方で、BUYMA に存在するすべての商品画像を無条件に検索対象にすると、処理量、インデックスサイズ、更新頻度、運用コストは大きくなります。検索品質のために対象を広げることと、安定して運用できる範囲に抑えることのバランスが重要です。

そのため私たちは、単純に「すべての画像を入れる」前提ではなく、検索対象範囲をどう決めるべきかを検討しました。

主に見ている観点は以下です。

  • 1商品あたり何枚の画像を対象にするか
    例:先頭画像だけで十分か、複数画像を含めるべきか
  • 検索体験への影響
    例:対象画像を増やすことで、ユーザーにとって有用な候補がどれだけ増えるか
  • インデックス更新への影響
    例:データ量が増えたときに、更新処理や再構築が運用上問題ないか
  • コストへの影響
    例:処理コスト、保存コスト、検索インデックスの運用コストが予算内に収まるか

ここで重要なのは、検索対象を広げること自体を目的にしないことです。

画像を増やせば、理論上は検索候補の幅が広がります。しかし、ユーザーにとって有用な検索結果が増えないのであれば、処理量やコストだけが増えてしまいます。

逆に対象を絞りすぎると、検索結果の多様性や網羅性が下がる可能性があります。 そのため、画像枚数や対象範囲は固定的に決めるのではなく、検索品質、コスト、運用安定性を見ながら調整できる設計にしています。

また、画像の前処理についても検証しました。

商品部分を切り抜いた画像を使う案も選択肢として検討しましたが、現時点では本番運用の柔軟性を重視し、元の商品画像をもとに検索対象を構築する方針を採用しています。

前処理を増やすと、検索品質が改善する可能性はあります。一方で、処理時間、失敗時の再実行、画像枚数変更時の柔軟性、運用コストにも影響します。

そのため、まずはシンプルな構成で安定運用できる状態を作り、必要に応じて追加の前処理を検討する方針にしました。

ボトルネックを見極めて処理を高速化する

画像検索基盤では、埋め込みベクトルを生成する処理の速度も重要です。

画像を埋め込みベクトルに変換する処理では GPU を利用しています。GPU を使うことで、数千万枚規模の画像処理を現実的な時間に近づけられます。

ただし、GPU を使えば自動的に処理全体が速くなるわけではありません。

実際に処理を動かしてみると、期待したほど速度が出ないケースがありました。調査すると、ボトルネックは GPU での計算そのものではなく、画像の読み込み処理にありました。GPU が計算を待っている時間が長く、十分に活用できていなかったのです。

そこで、画像の読み込み部分を並列化し、GPU に効率よくデータを渡せるように改善しました。

その結果、処理時間と実行コストの両方を大きく改善できました。

ここで得られた学びは、GPU を使うだけでなく、GPU を活かせるように処理全体を設計する必要があるということです。

計算処理、画像の読み込み、ネットワーク I/O、バッチサイズ、メモリ使用量などを確認しながら、全体として効率よく動くように調整する必要があります。

こうした改善によって、初期構築だけでなく、日々の差分更新も現実的な時間とコストで運用できるようになりました。

エニグモの開発で大切にしていること

今回紹介した画像検索基盤の開発では、プロダクトに組み込むための現実的な設計が重要でした。

具体的には、以下のような技術的な意思決定を積み重ねています。

  • 数千万枚規模の商品画像を処理できるデータ基盤を作る
  • Visual Intelligence 対応を含む複数機能から再利用できるAPIにする
  • 検索対象範囲を、品質・コスト・運用性のバランスで決める
  • GPU を活かせるように処理全体のボトルネックを改善する
  • 新しい機能を追加しても、基盤が複雑化しすぎない設計にする

エニグモでは、新しい技術を使うことだけを目的にするのではなく、BUYMA のユーザー体験を良くするために、技術をどう組み合わせ、どう運用可能な形に落とし込むかを大切にしています。

Visual Intelligence 対応も、その取り組みの一つです。

iOS の Visual Intelligence を使うことで、ユーザーは気になったアイテムや画像を起点に、BUYMA の商品と出会いやすくなります。

その裏側には、数千万枚規模の商品画像を扱うデータ処理、クラウドアーキテクチャ、API 設計、検索品質、コスト最適化など、さまざまな技術要素があります。

私たちはこれからも、BUYMA で商品と出会う体験をより自然で便利なものにするために、画像検索基盤の改善に取り組んでいきます。


株式会社エニグモ すべての求人一覧

hrmos.co

BUYMA検索・MLOps基盤の裏側を紹介します~マイクロサービス化から生成AI活用まで~

はじめに

こんにちは、AIテクノロジーグループの検索チームです。

昨年公開した エニグモのAI活用を支える「AIテクノロジーグループ」について紹介します! では、グループ全体の体制と各チームの役割を紹介しました。
本記事ではそのなかの検索チームに焦点を当て、日々どんなシステムを運用し、どんな案件を進めているかをもう一段詳しくお伝えします。

検索チームは名前のとおり BUYMA の検索システムを担当していますが、それだけではありません。
データサイエンティストが開発したモデルを安定して動かす MLOps と、生成AIを使ったシステムの実装・PoC も担っています。検索基盤から機械学習の本番化、AI の実装までを同じチームが見ることで、インフラからアプリケーションまで一気通貫で課題を解けるのがこのチームの特徴です。

対象読者としては、検索・MLOps・データ基盤まわりのエンジニアの方を想定しています。検索エンジニアという職種は専門性が高く、会社によって担当範囲が大きく違うものと思われます。BUYMA の検索チームが実際に何をしているか、その具体性を示し、この領域のイメージを持ってもらうことが、この記事の目的です。

検索チームの役割

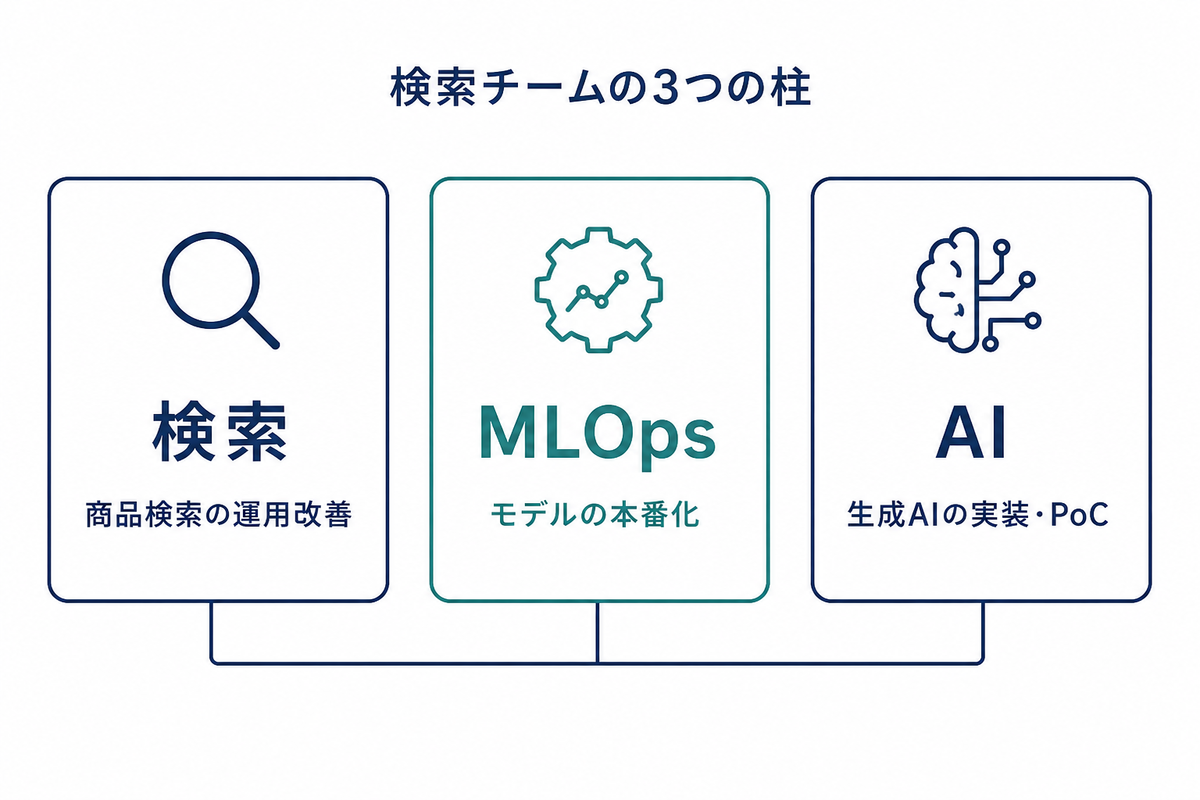
検索チームの業務は、次の3つの柱で整理できます。グループ紹介記事で触れた内容を、本記事では案件の粒度まで落とします。

  1. BUYMA の検索システムの運用改善
    大小あわせて8つの検索システムを運用し、その中核である商品検索では、ユーザーが探している商品を見つけられる状態を維持する。
  2. MLOps
    データサイエンティストが開発したモデルを、求められるレイテンシ・可用性・セキュリティを満たす形で本番に載せ、繰り返し改善できるサイクルをつくる。
  3. AIシステムの開発・PoC
    生成AIをはじめとするサービスを使い、BUYMA 向けの AI 機能を実装し、PoC で終わらせず運用に載るところまで持っていく。

検索チームの3つの柱。検索、MLOps、生成AIの実装・PoC

担当範囲は検索エンジンそのものにとどまりません。検索API、商品データの投入、中間DB(MySQL)、クラスタ、監視、CI/CD まで、検索と機械学習サービスが動くための一式を見ています。
これらの基盤は Google Cloud(以下、GCP) 上で運用しており、GKE、Cloud Run、Vertex AI などを組み合わせて構成しています。

検索システムの運用改善

検索システムの運用改善では、まず「検索が止まると何が起きるか」、次に「なぜ本体から独立できたか」、最後に「独立したからこそ進んでいる Elasticsearch への載せ替え」の順で書きます。検索を止めないことが前提で、そのうえで基盤を進化させる、というのがこの領域の進め方です。

1. 検索が止まると、発見も購入も止まる

BUYMA は世界中のファッションアイテムを購入できるマーケットプレイスです。
出品中約630万点のなかから、ユーザーが「これだ」と思える商品にたどり着く。その入口が検索です。キーワードやカテゴリ、ブランド、価格などの条件を組み合わせて探す体験が、発見と購入を支えています。
ピーク時の検索リクエストは約400 RPS に達します。検索が止まると、画面は残っていても、購入までの導線が途切れます。
サービスの主軸を担っている、という実感はここにあります。

絞り込みやファセット、並び順を含めた現行の検索体験を維持したまま、基盤を進化させていく必要があります。

検索チームが管理している検索システムは、大小あわせて8つあり、規模も用途もさまざまです。本記事ではそのうち、ユーザーの発見と購入に直結する商品検索に絞って書きます。

商品検索では、GKE 環境の更新、中間DBの MySQL、検索API、インデックス更新までを一体で見ています。いまは検索を止めない運用と基盤更新が中心で、検索結果の精度をよりよくしていくのはその先です。

検索システムの変遷については、以前の刷新の記録もあります。

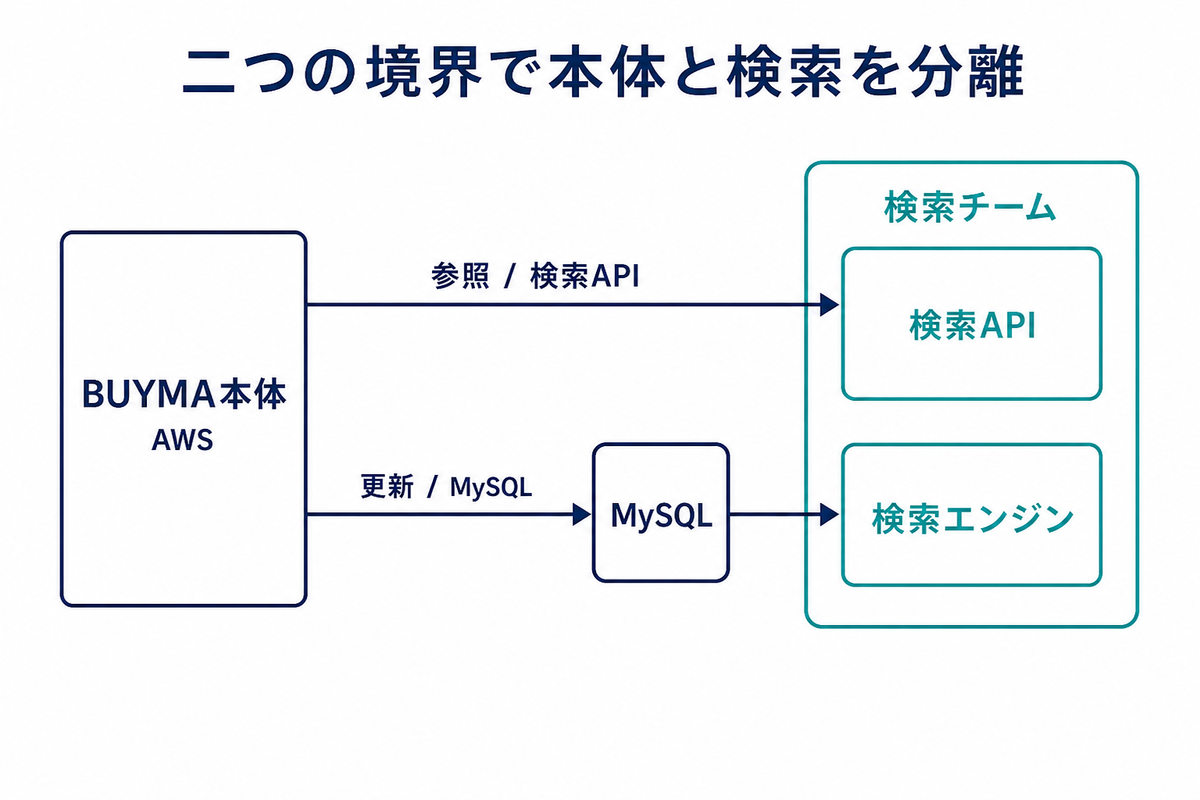
2. GCP 移設と同時に境界を設け、BUYMA 本体から独立できた

2024年7月に、大小あわせて8つの検索システムをすべて GCP へ移設しました。移設と同時に、BUYMA 本体との境界も設けています。

【当時の課題】
移設前は、検索の大きな変更が BUYMA 本体(Rails / PHP 側)のリリースサイクルに引きずられやすい構造でした。検索エンジンのインデックスの洗い替えなどを、本体と切り離して進めにくい状態です。

【設けた2つの境界】

  • 参照: 本体は検索エンジンの実装を意識せず、検索APIのインタフェースを通じて検索を利用する
  • 更新: 商品データの更新は、MySQL を挟んで検索側へ渡す

検索APIと検索エンジンは、検索チームのリポジトリとデプロイで完結します。この境界があることで、検索側の基盤変更が BUYMA 本体のリリースを待つ必要がなくなりました。

参照は検索API、更新はMySQL

8つすべてが同じ切り出し方になっているわけではありません。
商品検索をはじめとする主要な検索は、検索APIを境界に独立した構成で運用しています。残りのシステムは GCP 上で動いていますが、本体との結合の度合いはそれぞれ異なります。

【独立して進めるようになったこと】
独立した検索では、検索領域だけの案件を、検索チームの裁量で企画・検証・リリースしやすくなったことが大きいです。マイクロサービス化の効果は、運用が楽になることだけではありません。
たとえば次のような業務を、本体の大規模リリースに乗せることなく進められます。

  • 検索クラスタの構成変更やスケール
  • インデックスの投入パイプラインの刷新
  • 検索APIの置き換え
  • 検索エンジンそのものの検証と段階的な載せ替え
  • 辞書やマッピングの更新を、検索を止めずに反映する仕組み

通常は BUYMA 本体が従来どおり検索APIを呼べばよく、裏側の実装は検索チームが差し替えられます。デプロイは検索側で完結します。インタフェースやデータの投入口を変えるときだけ、本体側のリクエスト処理や更新処理まで検索チームが担います。専門性の高い検索の問題を、検索ドメインの中で完結して解ける状態です。検索を独立したプロダクトとして扱える、というのがいまの進め方の前提です。

3. Solr から Elasticsearch への載せ替えを、検索チームのペースで進める

独立して案件を進められるようになった具体例が、現在進行中の Solr から Elasticsearch への移行です。

【当時の課題】
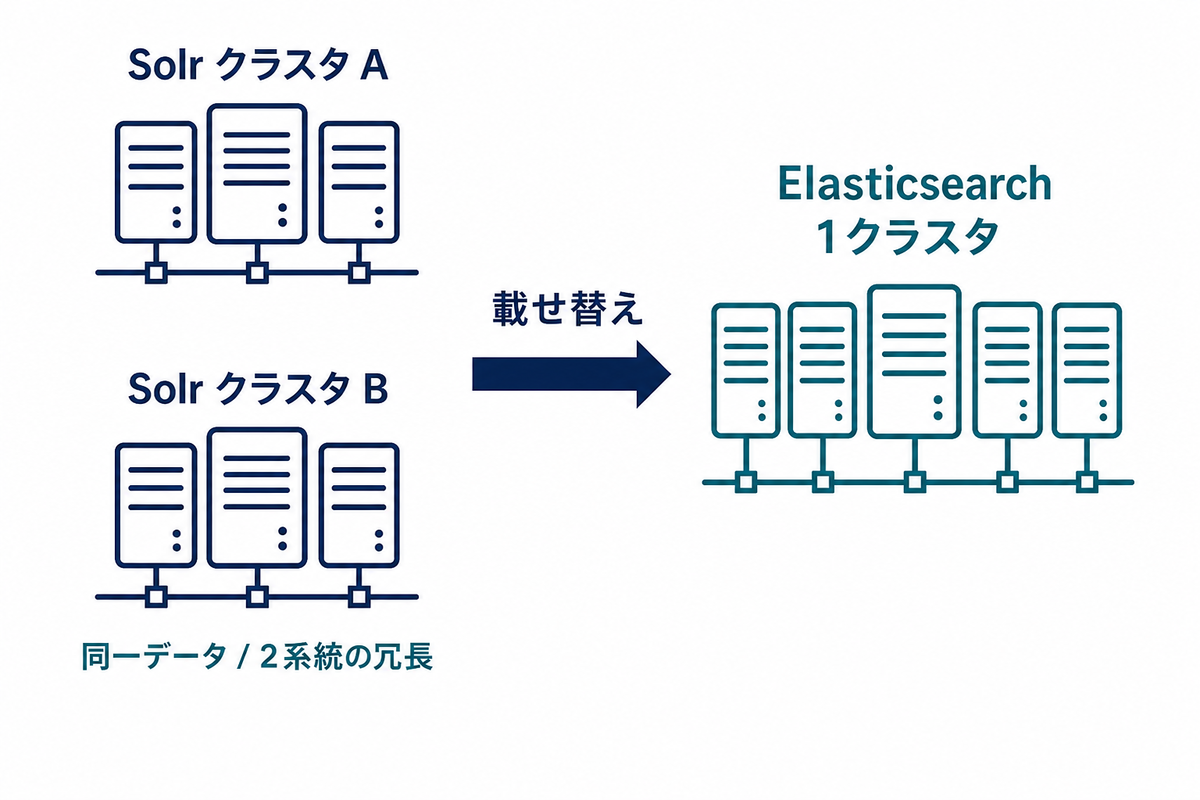
商品検索を支えているのは Apache Solr です。GCP 上で同一データを持つ2クラスタ、合計24ノードの冗長構成です。スケールや運用の柔軟性を上げたくても、本体と結合したままではエンジンごと変える判断は現実的ではありませんでした。

いまは同じ GCP 上で、Elasticsearch への置き換えを検証・構築しています。

【移行で外せない要件】

  • 出品中約630万点の商品を対象にした全文検索
  • ブランド・カテゴリ・価格などのファセット
  • 現行に近い並び順・グループ化
  • ピーク約400 RPS でも、ユーザー向けの応答速度を維持すること
  • インデックスの洗い替えのために検索を止めないこと

【解決へのアプローチ】

  • エンジン選定
    フルマネージドの検索サービスも検討しましたが、ファセットや複雑なソートを現行どおり載せるには、カスタマイズの余地が足りませんでした。既存の GCP 環境との統合のしやすさも踏まえ、Elasticsearch を GKE 上で運用する方針にしています
  • クラスタ構成
    Solr では安定運用のために必要だった2クラスタの冗長構成を、Elasticsearch では1クラスタにまとめる想定です
  • 検索APIの刷新
    検索APIとデータ投入も検索システム側で作り直しています。本体向けのインタフェースは現行に合わせつつ、裏側は Solr 前提の実装から切り離します。現行の検索APIは Python で、CPU 使用率が高く、アクセスが増えると 20〜30 インスタンスが起動し、コストも増えやすい状態です。新しいAPIは Go に書き換え、Cloud Run 上に設置済みですが、本番トラフィックの切替はこれからです
  • クエリの見直し
    Solr 向けのクエリをそのまま写したところ、見た目の検索結果は近づけたつもりでも、本番相当の負荷をかけるとおよそ200 RPS で頭打ちし、ノードの CPU が飽和しました。現行の検索体験は残したまま何度もクエリの組み立てを見直し、ピーク約400 RPS の要件に乗せられたときは大きな達成感がありました

現行 Solr は同一データの2クラスタ。Elasticsearch は1クラスタにまとめる

検索がマイクロサービスとして独立しているからこそ、現行 Solr を止めずに並行して検証し、検索チームのペースで載せ替えを進められています。

MLOps:モデルを「定期的に、安全に」本番へ載せる

検索チームは、もともと検索エンジニアリングの専任でした。
推薦や機械学習の案件が増えるにつれて、モデルを本番で動かし続ける基盤、いわゆる MLOps も担当するようになりました。

実験を本番の定期ジョブに載せ、運用を回す

【役割分担】
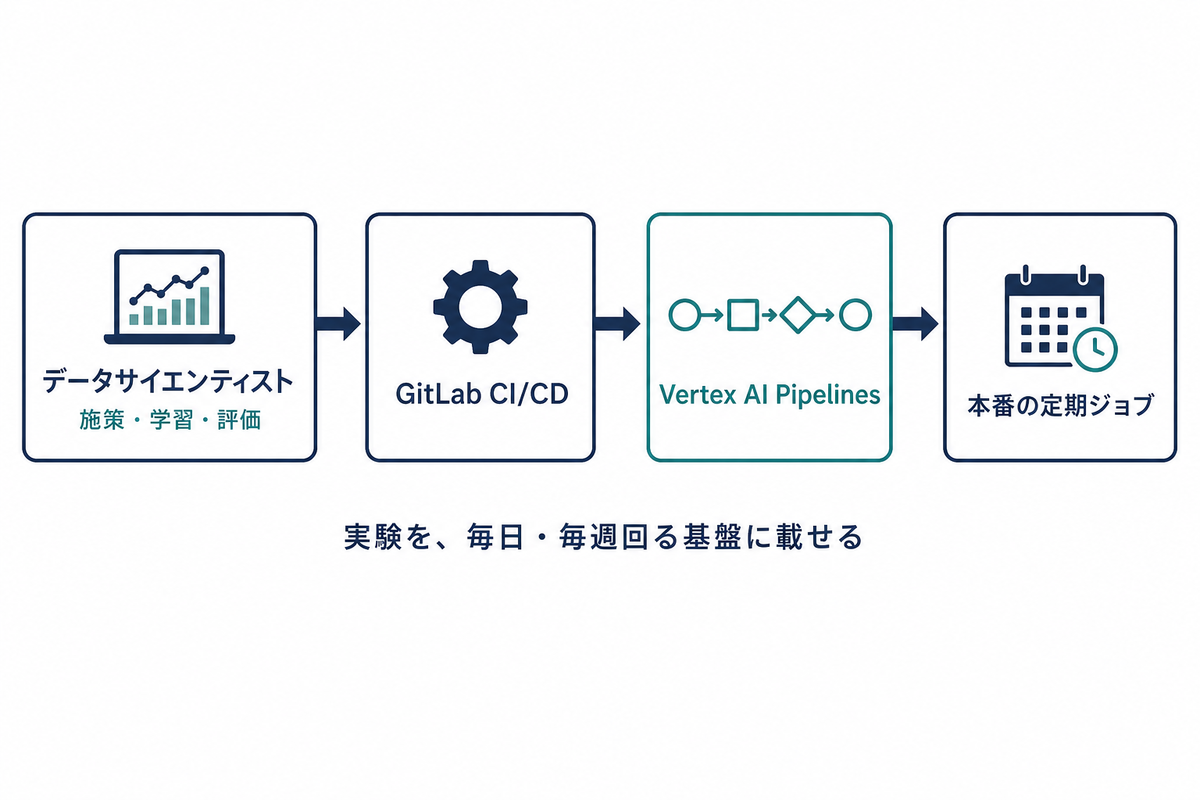
データサイエンティストは、施策の設計、特徴量、学習、評価を担います。検索チームは、その成果物がオンラインの推論でも、毎日・毎週のバッチでも、想定した品質で動き続けるための実行基盤を担います。

不正検知については、分析・導入判断の経緯を別記事でも紹介しています。検索チームの役割は、そうしたモデルを「検証で終わらせず、運用に耐えるサービス」にする側です。

【基盤の構成】
学習・推論は Vertex AI Pipelines(Kubeflow Pipelines)上のパイプラインとして定義し、前処理・学習・予測・評価などのコンポーネントはコンテナイメージとしてバージョン管理します。GitLab CI/CD でテスト、ビルド、デプロイまでつなぎ、推論結果を下流のサービスやバッチが受け取れる形で届けます。
パイプラインには、推薦や不正対策、定期バッチで回すスコア系など、オンラインの推論とバッチの両方を載せています。

データサイエンティストの実験を、CI/CD と Vertex AI Pipelines を経て形にする

【いちばん詰まったところ:バージョン整合】
パイプライン定義、コンポーネント、下流のジョブで共通ライブラリを使い回すときのバージョン整合です。片方だけ新しいイメージに載せ替えると、学習は通っても、推論側で想定どおり動かないことがあります。派手な障害ではないのですが、原因の切り分けに時間がかかるタイプです。コンポーネントとパイプラインのバージョンを分け、共通ライブラリの整合を取りながら回すようにしたことで、大きな安心感を得られました。

【この領域の面白さ】
機械学習システムは、一度出せば終わりではありません。データが変わり、モデルが更新され、しきい値も動きます。そのたびに同じ品質で出し直せる状態を維持します。レスポンス速度や可用性、セキュリティは、検索APIと同じ目線で設計します。
ここでの面白さは、アルゴリズムそのものというより、実験を本番の定期ジョブに載せ、運用を回せる状態にすることです。

AIシステムの開発・PoC

以前は検索運用と MLOps が主でしたが、生成AIの API が実用的になったこともあり、AI を使ったシステムの開発や PoC も担当するようになっています。
テキストや画像を対象にしたチェック処理を本番に載せるほか、商品検索とつながる「AIでさがす」にも関わっています。

生成AIによる感情分析・各種チェック

【対象にしているもの】
BUYMA は、出品者と購入者がメッセージを交わす CtoC の場でもあります。正当な商品のやりとり(在庫、サイズ、色味、配送追跡、公式サイトとの照合)と、スパム・フィッシング・外部誘導を切り分ける必要があります。

【ルールベースだけでは足りない理由】
ルールベースだけでは、新しい手口に追いつけません。逆に「外部URLがある」「BUYMA の外のサイトだ」だけで止めると、正常な購入会話まで不可となってしまいます。

【実装しているチェック】
検索チームでは Gemini を使い、次のようなチェックをマイクロサービスとして実装しています。

  • 問い合わせメッセージのスパム・フィッシング判定
  • 感情分析など、テキストのトーンやリスクを見る処理
  • 画像に含まれる、外部サイトへの誘導につながりやすい要素の検出

【運用上の判断】
同期の API と、まとめて処理するバッチの両方があります。過検知と見逃しのどちらを許容するかは、カスタマーサポートや不正対策の運用チームとすり合わせます。モデルの世代が上がったときは、精度・速度・コストのバランスを見て載せ替えるかどうかを決めます。速いが高コスト、あるいは高精度だがレイテンシが合わない、といった上位モデルを見送る判断もここに含まれます。

【BUYMAドメインの制約】
検索で「現行の体験を維持したまま裏側を差し替える」のと同じで、生成AIでも、まずドメインの制約から設計します。ファッションの CtoC では、韓国・欧米の正規 EC の URL や配送会社の追跡リンクは日常的に登場します。その文脈を無視した汎用のスパム判定では、実運用には耐えません。

生成AIと商品検索の接点:「AIでさがす」

BUYMA の「AIでさがす」は、記事コンテンツを根拠にした提案へと進化しています。
ここは、検索チームが運用する商品検索APIと、生成AI側のキーワード生成・文書検索が接続する領域です。検索基盤が独立していることで、AI 側の変更と、商品検索エンジン側の変更を並行して進められます。

これから取り組むこと

検索チームとして、目の前にある大きな業務は次のようなものです。

  • Elasticsearch の品質確認と、Go 製検索APIを含めたトラフィックの段階的な切替
  • 独立した検索基盤の上で、検索結果の精度をよりよくしていくこと
  • 推薦・不正検知などの ML パイプラインを、より安定して回し、より載せやすくすること
  • 生成AIのチェックや AI 検索を、既存の検索・ML 基盤と無理なくつなぐこと

「完成した基盤を保守する」フェーズではありません。切り離した検索プラットフォームの上で、エンジンも ML も AI も、まだ載せ替えと拡張の途中にあります。新メンバーには、アーキテクチャ設計から主導していただく余地が十分にあります。
インフラから API、データ、評価までを、同じチームで担っているのも醍醐味の一つです。

さいごに

検索チームは、出品中約630万点を支える商品検索をはじめ、BUYMA の検索を止めないことと、機械学習と生成AIを本番に載せることを並行して実施しています。
2024年の GCP 移設で検索APIを境界にして商品検索を独立させたことが、いまの Elasticsearch 移行のような「検索単体の大きな案件」を可能にしています。

現在は検索チームとしての幅を広げ、検索基盤・MLOps・生成AIまでを見ています。
今後はデータ基盤チーム等と統合し、よりプラットフォーム全体を見る体制へ変遷していく予定です。検索に閉じず、データを集め、モデルを回し、サービスとして届けるところまでを同じ視点で扱える場が、さらに広がっていくと考えています。

ここまで、いま私たちが担当しているものと、これから広がっていく業務の範囲を書いてきました。少しでも業務イメージが伝われば幸いです。


株式会社エニグモ すべての求人一覧

hrmos.co

AI導入でカスタマーサービス対応はどう変わる?Notion AI・Cursor活用の実践事例

こんにちは。 エニグモのWebアプリケーションエンジニアのレミーです!

カスタマーサービスに寄せられる問い合わせは、仕様確認から不具合の疑いまで内容が幅広く、エンジニアが対応にかかわる場面も少なくありません。近年はこのカスタマーサービス対応の現場でも、Notion AIやCursorといったAIツールの活用が急速に進んでいます。

この記事では、私たちのエンジニアチームがNotion AIとCursorをカスタマーサービス対応に取り入れたことで、業務がどう変わったのかを、導入前と導入後を比較しながら紹介します。「AIでカスタマーサービス対応は本当にラクになるのか?」を検討している方の参考になれば幸いです。

AIと協働してカスタマーサービス対応を進めるエンジニアのイラスト

エンジニアチームにおけるカスタマーサービス対応とAI活用

カスタマーサービスチームから寄せられる問い合わせは、仕様確認・運用相談・不具合の疑いなど多岐にわたります。エンジニア側はまず一次対応(トリアージ)を行い、必要に応じて各機能領域(出品/購入/サービス基盤/フロントエンド)の担当へ連携しながら、解決まで伴走する体制をとっています。

現在この流れの中で主に活用しているAIツールは、次の2つです。

  • Notion AI:問い合わせ内容の整理、過去の類似案件の検索、仕様ドキュメントの要約、議事録の作成
  • Cursor:サービスのコードベース調査、該当ロジックの特定、修正案やデータ補正SQLのドラフト作成

どちらも「人の判断を置き換える」ためではなく、判断に必要な情報を早く揃えるために使っている、という感覚が実態に近いです。

Notion AIとCursorの使い分けイメージ

AI導入前のカスタマーサービス対応で起きていた課題

AI導入前は、特に次のような部分に時間がかかっていました。

  • 問い合わせを読んで、そもそもどの領域の話なのかを判断するまでに時間がかかる
  • 「これ、前にも似た問い合わせがあった気がする」という、記憶に頼った探索
  • 仕様が明文化されていない領域では、コードを読み進めるところから調査が始まる
  • 調査内容をドキュメントに残す作業が後回しになり、結果的にナレッジが個人に溜まっていく

とりわけ自分の担当外の問い合わせが来たときの初動コストが大きく、「詳しい人に聞く」以外の選択肢を取りにくい状態でした。

AI導入前と導入後のカスタマーサービス対応を比較したイラスト

AI導入後、カスタマーサービス対応はどう変わったか

一次切り分け(トリアージ)の変化

問い合わせが起票された段階で、まずNotion AIに内容を渡し、次の3点を整理させるようになりました。

  • 事象の要約(何が / どの画面で / いつから)
  • 想定される担当領域
  • 過去の類似課題・関連する仕様ドキュメントへのリンク

これにより、問い合わせを開いてから「誰が見るべきか」を判断するまでの時間が明確に短くなりました。ワークスペース内の課題データベースやドキュメントを横断して検索してくれるため、記憶に頼った探索が減ったのが大きな変化です。

調査プロセスの変化

コードの調査ではCursorを使い、「この画面のこの挙動を制御しているロジックはどこか」という粒度で当たりをつけるようになりました。

  • 担当外の領域のコードでも、関連ファイルまでは短時間でたどり着ける
  • データ補正が必要な場合は、修正用SQLのドラフトを出させてから人がレビューする
  • ログ調査の観点(どのログを、どの時間帯で見るべきか)の洗い出しにも活用する

ただし、AIの出力をそのまま本番に反映することはありません。特にデータ補正SQLは、従来どおりレビューを経てから実行しています。AIが担うのは「調査の入口を早くする」ところまで、という線引きを意識しています。

ドキュメント・ナレッジ共有の変化

以前は後回しになりがちだった調査記録の整備も、変わってきました。

  • 対応中のやり取りやコメントをもとに、調査サマリのドラフトをAIに作らせる
  • 週次のカスタマーサービス対応プロジェクト単位で、対応内容を集約・整理する
  • 定例の議事録も、箇条書きメモから整った形に整形する

「書くのが面倒だから残さない」という状態が減り、属人化の解消という当初の課題に、実際に効いていると感じています。

これからのカスタマーサービス対応で取り組みたいこと

現時点で見えている、今後取り組みたいテーマを挙げます。

  • 一次切り分けの自動化:起票された課題に対し、想定領域・緊急度・関連ドキュメントを自動で提案する。チャット通知の時点で、ある程度整理された状態にする。
  • ナレッジの継続的な整備:調査手順のドキュメントを、実際の対応内容から継続的に更新し、「同じ問い合わせに何度も同じ調査をする」状態をなくす。
  • 傾向分析:問い合わせの多い機能を分析してプロダクト改善につなげる。リードタイムを計測し、ボトルネックを可視化する。
  • 判断の質を落とさない仕組みづくり:AIの出力を検証するチェック観点を明文化し、AIが誤った前提を出したケースを記録して振り返りに使う。

今後のカスタマーサービス対応改善ロードマップのイラスト

まとめ

AIを導入したからといって、カスタマーサービス対応が劇的にラクになった、という単純な話ではありません。実際に変わったのは、調査に取りかかるまでの時間と、ナレッジを残すハードルでした。

一方で、仕様の解釈や影響範囲の判断、本番データを触るかどうかの意思決定といった部分は、これまで通りエンジニアが責任を持って行っています。AIが情報収集を引き受けてくれる分、人が「判断」に使える時間が増えたというのが、現時点での率直な手応えです。

改善の余地はまだ多くありますが、定例で振り返りながら、少しずつ運用を整えていきたいと思います。

よくある質問(FAQ)

Q: AIにカスタマーサービス対応を任せると、対応品質は下がりませんか?

A: 品質に直結する判断(仕様解釈・影響範囲・本番データの変更可否)は、引き続き人が担っています。AIが担当するのは情報収集や調査の入口までで、最終判断は人が行う、という線引きを徹底しています。

Q: Notion AIとCursorはどう使い分けていますか?

A: Notion AIは問い合わせの整理・検索・要約・議事録などの「テキスト業務」、Cursorはコードベースの調査やSQLドラフト作成などの「開発業務」に使っています。

Q: データ補正SQLもAIに書かせて大丈夫ですか?

A: ドラフト作成には使いますが、そのまま実行はしません。従来どおり人のレビューを経てから本番に反映しています。

エニグモのセキュリティ最前線:DevSecOpsと攻めのガバナンスで全社を守る仕組みづくり

1. はじめに

こんにちは!エニグモのセキュリティチームです。

エニグモの中核事業の「BUYMA」は、世界中のパーソナルショッパーから商品を購入できる、会員数1,200万人超のCtoCのECプラットフォームです。 大規模かつグローバルなトラフィックを守るため、セキュリティの重要性は日々高まっています。

今回は、そんな当社におけるセキュリティチームの現在の取り組みや組織体制、そして今後注力していく技術的な課題についてご紹介します。 セキュリティエンジニアとしてエニグモで働く魅力や、リアルな業務の裏側が少しでも伝われば幸いです。

2. セキュリティ組織の体制とミッション

エンジニアリングの現場に根ざした「戦略的配置」

エニグモのセキュリティチームは、サービスエンジニアリング本部のインフラグループに所属しています。これは、セキュリティを単なる「管理・監査」の対象ではなく、サービスの信頼性を支える「エンジニアリング」の一部として捉えているためです。

各専門領域が集まるエンジニアリング組織の中に身を置くことで、最新の技術トレンドや開発のスピード感を共有しながら、実効性の高いセキュリティ施策をダイレクトに実装・反映できる「攻め」の体制を構築しています。

全社・グループ全体を網羅する広範なハブ組織

私たちのミッションは、自社サービスの開発現場に留まりません。専門家としての知見を活かし、グループ全体の安全をデザインする「ハブ」として、現在は主に以下のような領域でセキュリティ強化を推進しています。

  • 全社セキュリティ・ガバナンス: コーポレートITチームと連携し、社内システムからプロダクトまで一貫した安全性の担保とセキュリティ水準の底上げ。

  • 自社サービスのセキュアな開発支援: 「BUYMA」のサービス開発を担う開発とインフラ両方のエンジニアと連携し、安全なインフラ構築とエンジニアリングによる継続的な脆弱性対策の実施。

  • グループ全体のセキュリティ向上: エニグモおよび「BUYMA TRAVEL」をはじめとするグループ会社に対し、ルール策定支援や脆弱性情報の共有、対応手順の標準化を通じた防御力の強化。

  • 新規事業のセキュリティ・アセスメント: 事業立ち上げの初期フェーズから伴走する、セキュリティ設計やリスクの評価。

業務領域の整理と「シフトレフト」の志向

現在のチームでは「シフトレフト」を強く志向し、役割分担を明確にしています。 セキュリティエンジニアの業務領域は広く、とかく日々の運用・構築作業に忙殺されがちです。エニグモでは、WAFのテスト・本番環境への導入・デプロイ作業や、脆弱性スキャンツールの設定といった一部の運用・構築作業は、開発プロセスやインフラ運用の中に組み込み、各チームと役割を分担する体制としています。

一方で、CrowdStrikeなどのアラート一次対応をはじめとするセキュリティインシデントの監視や初動対応は、引き続きセキュリティチームが責任を持って担っています。これにより、現場のリアルな脅威動向を把握しつつ、「セキュリティ戦略の設計・ガバナンス・自動化の仕組みづくり」といった、よりセキュリティ要件の策定や設計といった高度で全社的なセキュリティ課題へ注力できる環境を作っています。

3. 具体的な施策・プロジェクトの紹介

直近で取り組んできたプロジェクトをいくつかご紹介します。

脅威情報の継続的な収集とインシデントへの迅速な対応

日々高度化するサイバー攻撃に対抗するため、多様な媒体から脅威・脆弱性情報を継続的に収集・分析しています。近年多発しているパッケージエコシステムを標的としたサプライチェーン攻撃(Mini Shai-Hulud等) や、NGINX Riftをはじめとするクリティカルな脆弱性が発表された際には、即座に影響調査を行い、開発チームと連携して安全なバージョンへの固定化や設定の回避策などの対応を迅速に進めました。

AWS WAFの運用高度化とDDoS対策のチューニング

Webアプリケーションを強固に保護するため、AWS WAFを本番導入し運用・改善を進めています。WAFの導入・デプロイにあたってはインフラチームが担い、セキュリティチームはルールの高度な分析とチューニングに専念する体制をとっています。 実際のDDoS攻撃のデータとメトリクスを分析した結果、標準のマネージドルールに依存するだけでなく、アクセス元のIPやネットワークアドレス単位でのレート制限を適切に設定することが防御に非常に有効であることを確認しました。現在は、これらの知見を活かした独自のルールチューニングや、悪意のあるIPアドレス(AbuseIP)の自動ブロックの仕組みなどの実装を進めています。

CNAPPの運用改善と高度化(マルチクラウドのセキュリティ強化)

AWSとGCPを利用するマルチクラウド環境において、クラウド全体のセキュリティポスチャを継続的に管理するため、すでにAWS Security HubおよびGCP Security Command Center(SCC)を導入しています。 現在は、これらのCNAPPツールを用いた運用の改善・高度化を進めており、増大し続けるFindingsの内優先的に対応が必要な重大な設定ミスや潜在的な攻撃を選別し、リスクベースで効率的に脆弱性を潰し込んでいく基盤づくりに注力しています。

AIツールの安全な利活用に向けたセキュリティルールの策定

開発効率化のためにAIコーディングツール(Cursor、Claude Code等)やMCP(Model Context Protocol)の導入機運が高まる中、生産性向上とセキュリティのバランスを取るためのルール作りを主導しています。リスクの高いコミュニティ製MCP(BigQuery連携など)の利用制限ルールの策定や、RAGシステムの構築に向けたセキュリティガイドラインの作成など、現場と連携しながら新しい技術を安全に活用するための「攻めのセキュリティガバナンス」を進めています。

社内セキュリティカルチャーの醸成とセキュア開発の推進

エニグモにはエンジニアを中心に毎週実施している社内勉強会「Hacker's Delight」があり、ここで月に1回程度セキュリティの啓発活動をおこなっています。サプライチェーン攻撃などの最新事例や攻撃デモを交え、技術的な面白さを共有しながら現場の解像度を上げる場づくりを大切にしています。

※ 社内勉強会「Hacker's Delight」についてはこちらをご覧ください。 https://www.wantedly.com/companies/enigmo/post_articles/940864

それに加え、技術者・非技術者それぞれに向けたセキュリティ教育やテストを毎年実施しています。また、「セキュア開発実施の手引き」の策定や、Googleドライブ等でのファイル運用ルールといった日常的なガイドラインの整備も行い、現場のメンバー一人ひとりが自律的にセキュリティを高められるカルチャー醸成に努めています。

4. これから取り組むべき技術的課題

エニグモのセキュリティをさらに進化させるため、今後以下のような技術的課題に注力していきます。

DevSecOpsの推進とSBOMの導入

プロダクト開発において利用するOSS等のパッケージ、ライブラリが膨大になる中、昨今、サプライチェーン攻撃や新たなクリティカルな脆弱性が報告された際、どのプロダクトのどこに影響があるのか、調査や特定に膨大な時間がかかってしまうリスクが増加しています。SAST/DASTや依存ライブラリの脆弱性スキャン(SCA)を自動化したり、SBOM(ソフトウェア部品表)の導入・管理体制を構築し、これらの攻撃や脆弱性の多発に対して、影響範囲を即座に特定・自動ブロックできる仕組みを実装していきます。

グループ企業・委託先を含めた全社セキュリティガバナンスの強化

主力事業であるBUYMA本体のセキュリティ対策は成熟しつつあるものの、事業の多角化に伴い、グループ会社や新規事業、外部委託先を含めたサプライチェーン全体で見ると、セキュリティレベルにばらつきが生じているという懸念があります。経営会議でも重要課題として挙がったデータガバナンスの強化に向け、エニグモが守るべき情報資産とリスクシナリオの可視化を進めてきました。今後はこのリスクベースアプローチを基盤とし、BUYMA事業だけでなく、BUYMA TRAVELやHOUSE REVOといったグループ会社全体のセキュリティ体制構築(Security Hubの全アカウント適用、運用体制の構築や、脆弱性診断の展開など)や、外部委託先の情報セキュリティ管理プロセスの高度化に注力していきます。

AIを取り巻く新たな脅威への対抗とセキュリティ業務のAI化

開発効率化のために各種AIツールの活用が急速に進む一方で、開発環境を狙うMiasmaワームやプロンプトインジェクションなどの新たなリスクへの対応方針が急務となっています。また、開発スピードの向上に対して、セキュリティチームの人的リソースだけで全件レビューを行うことの限界も見え始めてきました。これらのAIツールを悪用した新たな脅威に対応するガードレールの構築を進めていきます。また、OWASP LLM Top 10などをベースにしたセキュリティチェックリストの作成や、LLMを活用したセキュリティレビューの自動化など、セキュリティ業務自体のAI活用にも取り組んでいきます。

Policy as Codeを用いたガードレールの構築

セキュリティチェックを厳格化すればするほど、影響のない誤検知(ノイズ)の対応や軽微なアラートによって開発の手が止まってしまい、開発者体験(DX)や事業のリリーススピードを損なってしまうというジレンマがありました。「Critical/Highのみデプロイをブロックする」「影響のない誤検知(ノイズ)を自動除外する」など、開発者体験(DX)と事業スピードを損なわずに、開発チームが自律して修正できるプロセスを構築していきます。

5. エニグモでセキュリティエンジニアとして働く魅力ややりがい

エニグモのセキュリティエンジニアは、単なる監視や定常作業に留まりません。世界中のユーザーが利用する大規模CtoC・越境ECの「BUYMA」という特性上、個人間取引特有の不正利用やグローバル環境における複雑な脅威シナリオが存在し、それらに対する「攻防の面白さ」をダイレクトに味わえるのが大きな特徴です。 また、現在はBUYMA TRAVELやHOUSE REVOといったM&Aによるグループ企業の拡大や新規事業も加速しています。ビジネスモデルやシステム環境が多様化する中で、全社共通のガバナンスの「型」を自ら設計し、適用していくアーキテクトとしての大きな裁量があります。 経営層から事業部門、インフラ・開発チーム、グループ会社に至るまで、多様な関係者と円滑にコミュニケーションを図りながら、全社規模の防衛戦略をリードできるのは当社ならではの大きなやりがいだと感じています。 また、EM(エンジニアリングマネージャー)と協働し、AI等の新技術の活用ルール策定やモダンなDevSecOps環境の構築といった「技術的に面白い課題」に、専門家の立場から大きな裁量を持って挑戦できる環境が整っています。

6. おわりに

エニグモでは現在こうした課題に一緒に立ち向かってくれる仲間を探しています。 ぜひ、一緒にエニグモグループ、BUYMAの成長を支えるセキュリティ体制をつくっていきませんか。