こんにちは、エニグモのAIテクノロジーグループの太田です。
BUYMA では最近、Apple が iOS で提供している Visual Intelligence*1 に対応し、iPhone で見つけたアイテムや画像をきっかけに、BUYMAの商品を探しやすくする取り組みを進めています。
この仕組みに対応するには、ユーザーが見ている画像に近い商品を BUYMA の商品データの中から素早く探せる必要があります。そのために私たちは、大量の商品画像を検索可能な形に変換し、継続的に更新できる画像検索基盤を構築しました。
この記事では、Visual Intelligence 対応の裏側で、私たちがどのように画像検索基盤を設計し、運用できる形にしてきたかを紹介します。
画像検索をプロダクトに組み込むには、検索アルゴリズムだけでなく、数千万枚規模の商品画像を処理するデータ基盤、複数の機能から安全に使えるAPI設計、そして継続的に運用できるコスト設計が必要になります。
今回は、以下の観点から、BUYMA の画像検索基盤づくりを振り返ります。
- 数千万枚の商品画像を扱うためのデータ処理基盤
- 複数の機能から使いやすい API として設計する
- 検索対象範囲とコストをどう決めるか
- ボトルネックを見極めて処理を高速化する
- エニグモの開発で大切にしていること
数千万枚の商品画像を扱うためのデータ処理基盤
画像検索を実現するには、商品画像をあらかじめ 埋め込みベクトル(embedding) に変換しておく必要があります。
埋め込みベクトルとは、画像やテキストなどのデータを数値のベクトルとして表現したものです。類似した意味や特徴を持つデータ同士が、ベクトル空間上でも近くなるように表現されるため、画像検索や類似検索でよく使われます。
BUYMA では大量の商品画像を扱っており、検索対象となる画像は数千万枚規模になります。これを単純に1枚ずつ処理していては、処理時間が現実的ではありません。日々更新される商品データに追従するには、大量の画像を安定して処理できる仕組みが必要でした。
そこで私たちは、Google Cloud の Dataflow を使った分散処理基盤を構築しました。
Dataflow は、Apache Beam のパイプラインを実行できる Google Cloud のマネージドサービスです。Cloud Storage、BigQuery、Vertex AI Vector Search など、周辺の Google Cloud サービスと組み合わせやすい点も、今回の用途に合っていました。
検証では、「商品画像を取得 → モデルで埋め込みベクトルへ変換 → 検索インデックスに投入するためのデータを作成」という一連の処理を対象にしました。
処理件数、ワーカー数、処理時間、実行コストを確認しながら、次のような観点を見ています。
- 数千万枚規模に拡張したときに、処理時間が運用上許容できるか
- 日々の差分更新に追従できるか
- 処理時間とコストのバランスが取れているか
- 途中失敗時の再実行や復旧がしやすいか
この検証により、画像を一括で処理する初期構築と、日々の差分更新の両方を見据えたパイプライン設計ができました。
現在の処理は、概念的には以下のような流れです。
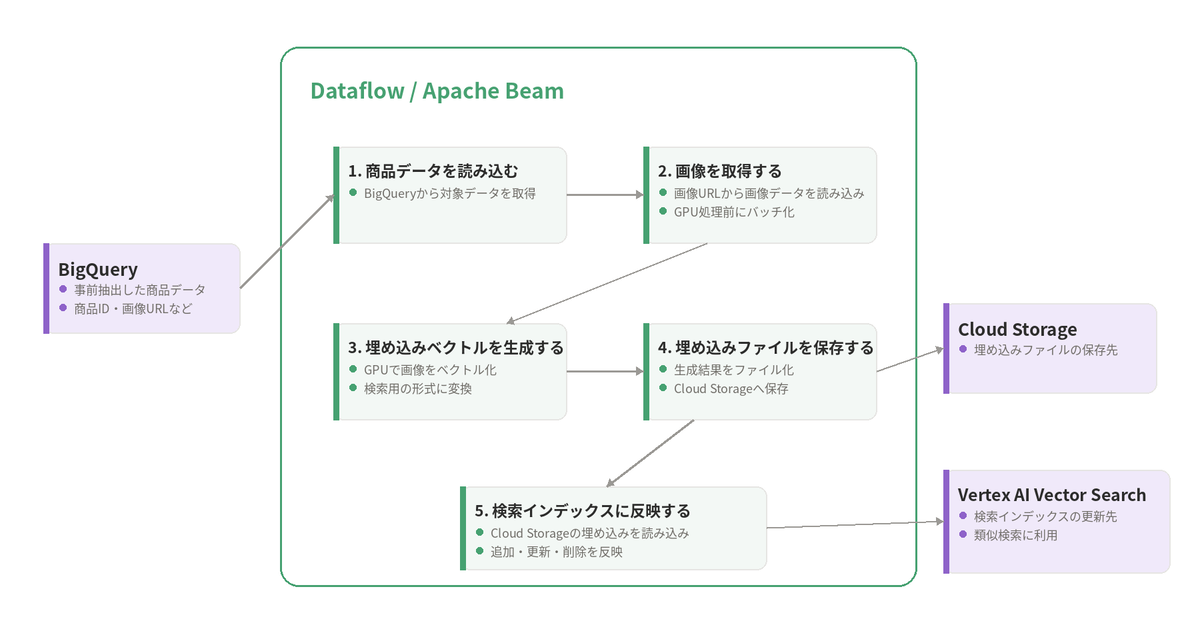
この基盤によって、数千万枚規模の商品画像を検索可能な形に変換し、Visual Intelligence 対応を含む画像検索機能の土台を作ることができました。
複数の機能から使いやすい API として設計する
画像検索基盤は、Visual Intelligence 対応だけに閉じたものではありません。
BUYMA の検索体験の改善や、出品支援など、画像を起点に商品を探す・提案する機能にはさまざまな応用先があります。そのため、特定の機能に密結合した実装にせず、複数の機能・用途から再利用しやすい API として設計しました。
基本構成は以下の4層です。
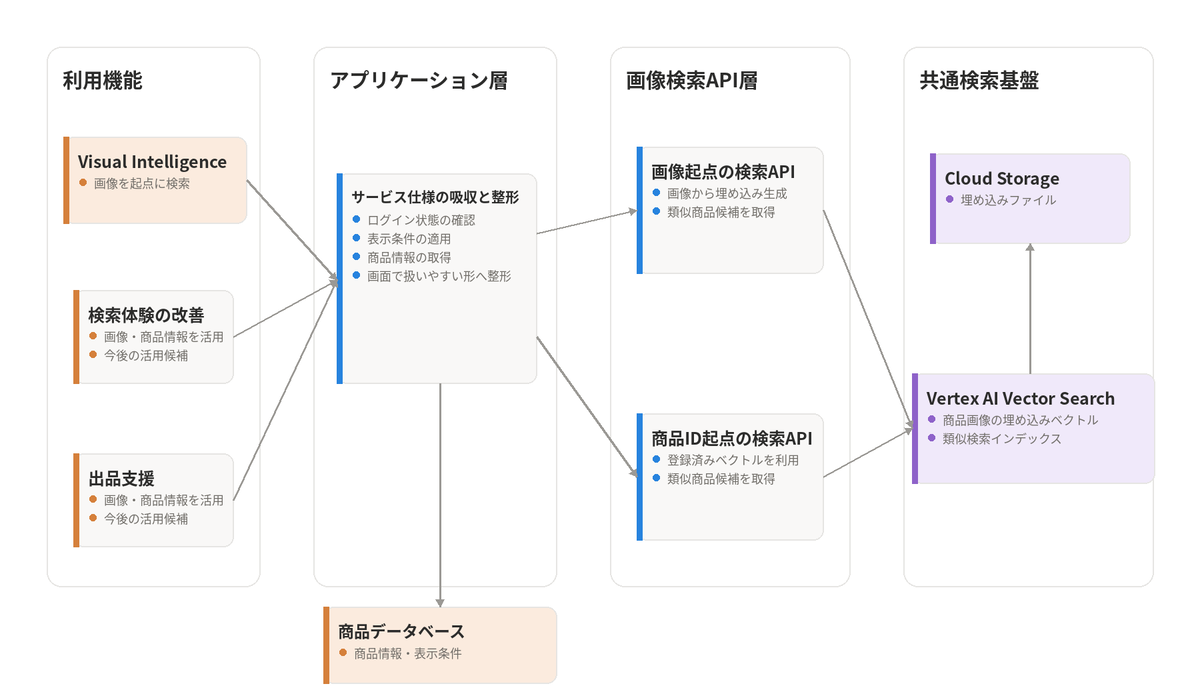
この構成では、BUYMA のサービス仕様に関わる処理と、画像検索そのものに関わる処理を、それぞれ扱いやすい層に分けています。
たとえば、ログイン状態の確認、商品情報の取得、販売状態や表示条件の適用、画面で扱いやすいレスポンスへの整形といった処理は、BUYMAのアプリケーション側で扱うほうが自然です。
一方で、商品IDや画像を入力として受け取り、埋め込みベクトルの生成や Vertex AI Vector Search への問い合わせを行う処理は、画像検索API層に閉じ込めたほうが扱いやすくなります。
この分け方により、アプリケーション側の開発者は画像検索API層の内部実装を詳しく知らなくても、BUYMA のサービス仕様に沿った形で画像検索の結果を扱えます。また、画像検索 API 層も特定の画面や機能に依存しすぎず、共通基盤として改善しやすい状態を保てます。
この構成には、次のようなメリットがあります。
- プロダクト側の仕様変更をアプリケーション層で吸収しやすい
- 画像検索 API 層を、特定の画面や機能に依存しすぎない形に保ちやすい
- 検索処理そのものの改善を、共通基盤側で進めやすい
- 新しい利用機能が増えたときに、どちらの層で対応すべきかを考えやすい
特に今後の拡張では、アプリケーション層で吸収すべき仕様なのか、画像検索 API 層に共通機能として持たせるべき処理なのかを切り分けることが重要になります。
たとえば、画面表示の都合や BUYMA 固有の表示条件であればアプリケーション層で扱い、検索ロジックや候補生成の共通処理であれば画像検索API層で扱う、といった判断です。
この切り分けを意識しておくことで、機能追加のたびに基盤が複雑化することを防ぎながら、検索体験の改善や出品支援など、複数の用途に展開しやすい状態を保てると考えています。
検索対象範囲とコストをどう決めるか
画像検索基盤では、検索対象を広げるほど、ユーザーが見つけられる商品候補は増えます。
一方で、BUYMA に存在するすべての商品画像を無条件に検索対象にすると、処理量、インデックスサイズ、更新頻度、運用コストは大きくなります。検索品質のために対象を広げることと、安定して運用できる範囲に抑えることのバランスが重要です。
そのため私たちは、単純に「すべての画像を入れる」前提ではなく、検索対象範囲をどう決めるべきかを検討しました。
主に見ている観点は以下です。
- 1商品あたり何枚の画像を対象にするか
例:先頭画像だけで十分か、複数画像を含めるべきか - 検索体験への影響
例:対象画像を増やすことで、ユーザーにとって有用な候補がどれだけ増えるか - インデックス更新への影響
例:データ量が増えたときに、更新処理や再構築が運用上問題ないか - コストへの影響
例:処理コスト、保存コスト、検索インデックスの運用コストが予算内に収まるか
ここで重要なのは、検索対象を広げること自体を目的にしないことです。
画像を増やせば、理論上は検索候補の幅が広がります。しかし、ユーザーにとって有用な検索結果が増えないのであれば、処理量やコストだけが増えてしまいます。
逆に対象を絞りすぎると、検索結果の多様性や網羅性が下がる可能性があります。 そのため、画像枚数や対象範囲は固定的に決めるのではなく、検索品質、コスト、運用安定性を見ながら調整できる設計にしています。
また、画像の前処理についても検証しました。
商品部分を切り抜いた画像を使う案も選択肢として検討しましたが、現時点では本番運用の柔軟性を重視し、元の商品画像をもとに検索対象を構築する方針を採用しています。
前処理を増やすと、検索品質が改善する可能性はあります。一方で、処理時間、失敗時の再実行、画像枚数変更時の柔軟性、運用コストにも影響します。
そのため、まずはシンプルな構成で安定運用できる状態を作り、必要に応じて追加の前処理を検討する方針にしました。
ボトルネックを見極めて処理を高速化する
画像検索基盤では、埋め込みベクトルを生成する処理の速度も重要です。
画像を埋め込みベクトルに変換する処理では GPU を利用しています。GPU を使うことで、数千万枚規模の画像処理を現実的な時間に近づけられます。
ただし、GPU を使えば自動的に処理全体が速くなるわけではありません。
実際に処理を動かしてみると、期待したほど速度が出ないケースがありました。調査すると、ボトルネックは GPU での計算そのものではなく、画像の読み込み処理にありました。GPU が計算を待っている時間が長く、十分に活用できていなかったのです。
そこで、画像の読み込み部分を並列化し、GPU に効率よくデータを渡せるように改善しました。
その結果、処理時間と実行コストの両方を大きく改善できました。
ここで得られた学びは、GPU を使うだけでなく、GPU を活かせるように処理全体を設計する必要があるということです。
計算処理、画像の読み込み、ネットワーク I/O、バッチサイズ、メモリ使用量などを確認しながら、全体として効率よく動くように調整する必要があります。
こうした改善によって、初期構築だけでなく、日々の差分更新も現実的な時間とコストで運用できるようになりました。
エニグモの開発で大切にしていること
今回紹介した画像検索基盤の開発では、プロダクトに組み込むための現実的な設計が重要でした。
具体的には、以下のような技術的な意思決定を積み重ねています。
- 数千万枚規模の商品画像を処理できるデータ基盤を作る
- Visual Intelligence 対応を含む複数機能から再利用できるAPIにする
- 検索対象範囲を、品質・コスト・運用性のバランスで決める
- GPU を活かせるように処理全体のボトルネックを改善する
- 新しい機能を追加しても、基盤が複雑化しすぎない設計にする
エニグモでは、新しい技術を使うことだけを目的にするのではなく、BUYMA のユーザー体験を良くするために、技術をどう組み合わせ、どう運用可能な形に落とし込むかを大切にしています。
Visual Intelligence 対応も、その取り組みの一つです。
iOS の Visual Intelligence を使うことで、ユーザーは気になったアイテムや画像を起点に、BUYMA の商品と出会いやすくなります。
その裏側には、数千万枚規模の商品画像を扱うデータ処理、クラウドアーキテクチャ、API 設計、検索品質、コスト最適化など、さまざまな技術要素があります。
私たちはこれからも、BUYMA で商品と出会う体験をより自然で便利なものにするために、画像検索基盤の改善に取り組んでいきます。
株式会社エニグモ すべての求人一覧
