はじめに
こんにちは、AIテクノロジーグループの検索チームです。
昨年公開した エニグモのAI活用を支える「AIテクノロジーグループ」について紹介します! では、グループ全体の体制と各チームの役割を紹介しました。
本記事ではそのなかの検索チームに焦点を当て、日々どんなシステムを運用し、どんな案件を進めているかをもう一段詳しくお伝えします。
検索チームは名前のとおり BUYMA の検索システムを担当していますが、それだけではありません。
データサイエンティストが開発したモデルを安定して動かす MLOps と、生成AIを使ったシステムの実装・PoC も担っています。検索基盤から機械学習の本番化、AI の実装までを同じチームが見ることで、インフラからアプリケーションまで一気通貫で課題を解けるのがこのチームの特徴です。
対象読者としては、検索・MLOps・データ基盤まわりのエンジニアの方を想定しています。検索エンジニアという職種は専門性が高く、会社によって担当範囲が大きく違うものと思われます。BUYMA の検索チームが実際に何をしているか、その具体性を示し、この領域のイメージを持ってもらうことが、この記事の目的です。
検索チームの役割
検索チームの業務は、次の3つの柱で整理できます。グループ紹介記事で触れた内容を、本記事では案件の粒度まで落とします。
- BUYMA の検索システムの運用改善
大小あわせて8つの検索システムを運用し、その中核である商品検索では、ユーザーが探している商品を見つけられる状態を維持する。 - MLOps
データサイエンティストが開発したモデルを、求められるレイテンシ・可用性・セキュリティを満たす形で本番に載せ、繰り返し改善できるサイクルをつくる。 - AIシステムの開発・PoC
生成AIをはじめとするサービスを使い、BUYMA 向けの AI 機能を実装し、PoC で終わらせず運用に載るところまで持っていく。
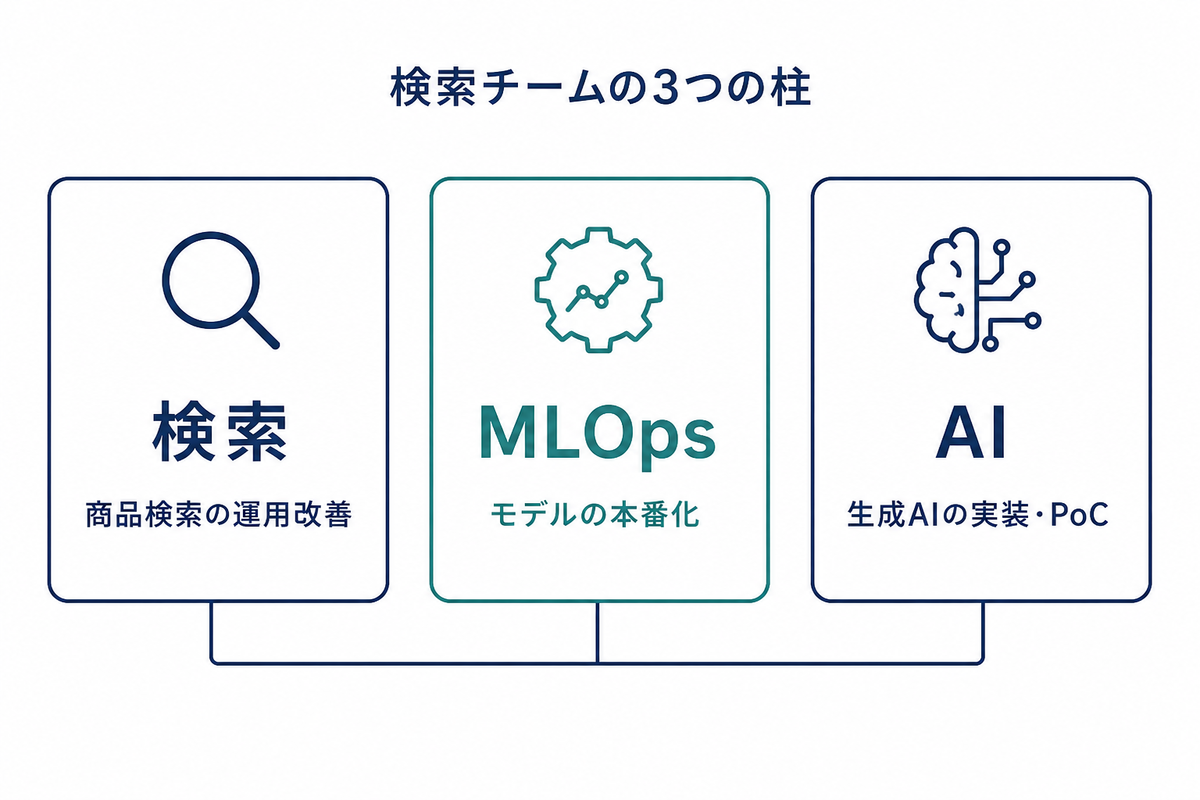
担当範囲は検索エンジンそのものにとどまりません。検索API、商品データの投入、中間DB(MySQL)、クラスタ、監視、CI/CD まで、検索と機械学習サービスが動くための一式を見ています。
これらの基盤は Google Cloud(以下、GCP) 上で運用しており、GKE、Cloud Run、Vertex AI などを組み合わせて構成しています。
検索システムの運用改善
検索システムの運用改善では、まず「検索が止まると何が起きるか」、次に「なぜ本体から独立できたか」、最後に「独立したからこそ進んでいる Elasticsearch への載せ替え」の順で書きます。検索を止めないことが前提で、そのうえで基盤を進化させる、というのがこの領域の進め方です。
1. 検索が止まると、発見も購入も止まる
BUYMA は世界中のファッションアイテムを購入できるマーケットプレイスです。
出品中約630万点のなかから、ユーザーが「これだ」と思える商品にたどり着く。その入口が検索です。キーワードやカテゴリ、ブランド、価格などの条件を組み合わせて探す体験が、発見と購入を支えています。
ピーク時の検索リクエストは約400 RPS に達します。検索が止まると、画面は残っていても、購入までの導線が途切れます。
サービスの主軸を担っている、という実感はここにあります。
絞り込みやファセット、並び順を含めた現行の検索体験を維持したまま、基盤を進化させていく必要があります。
検索チームが管理している検索システムは、大小あわせて8つあり、規模も用途もさまざまです。本記事ではそのうち、ユーザーの発見と購入に直結する商品検索に絞って書きます。
商品検索では、GKE 環境の更新、中間DBの MySQL、検索API、インデックス更新までを一体で見ています。いまは検索を止めない運用と基盤更新が中心で、検索結果の精度をよりよくしていくのはその先です。
検索システムの変遷については、以前の刷新の記録もあります。
2. GCP 移設と同時に境界を設け、BUYMA 本体から独立できた
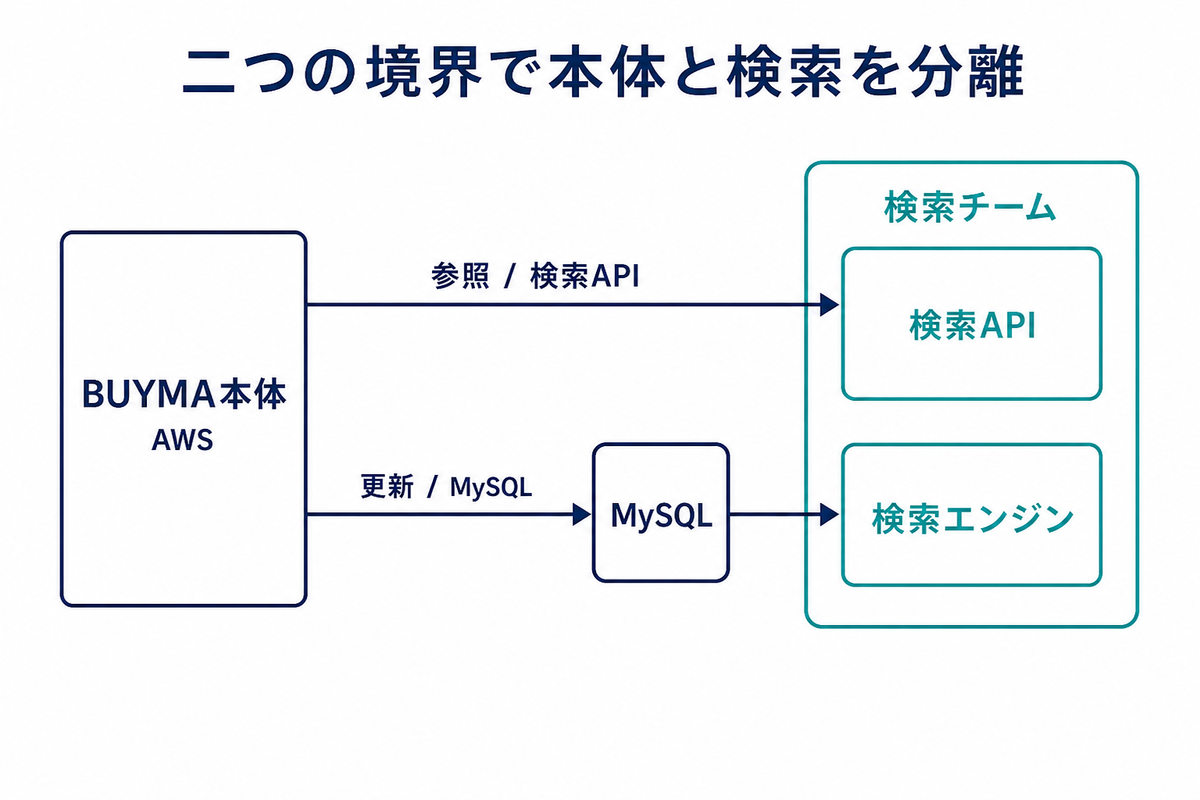
2024年7月に、大小あわせて8つの検索システムをすべて GCP へ移設しました。移設と同時に、BUYMA 本体との境界も設けています。
【当時の課題】
移設前は、検索の大きな変更が BUYMA 本体(Rails / PHP 側)のリリースサイクルに引きずられやすい構造でした。検索エンジンのインデックスの洗い替えなどを、本体と切り離して進めにくい状態です。
【設けた2つの境界】
- 参照: 本体は検索エンジンの実装を意識せず、検索APIのインタフェースを通じて検索を利用する
- 更新: 商品データの更新は、MySQL を挟んで検索側へ渡す
検索APIと検索エンジンは、検索チームのリポジトリとデプロイで完結します。この境界があることで、検索側の基盤変更が BUYMA 本体のリリースを待つ必要がなくなりました。
8つすべてが同じ切り出し方になっているわけではありません。
商品検索をはじめとする主要な検索は、検索APIを境界に独立した構成で運用しています。残りのシステムは GCP 上で動いていますが、本体との結合の度合いはそれぞれ異なります。
【独立して進めるようになったこと】
独立した検索では、検索領域だけの案件を、検索チームの裁量で企画・検証・リリースしやすくなったことが大きいです。マイクロサービス化の効果は、運用が楽になることだけではありません。
たとえば次のような業務を、本体の大規模リリースに乗せることなく進められます。
- 検索クラスタの構成変更やスケール
- インデックスの投入パイプラインの刷新
- 検索APIの置き換え
- 検索エンジンそのものの検証と段階的な載せ替え
- 辞書やマッピングの更新を、検索を止めずに反映する仕組み
通常は BUYMA 本体が従来どおり検索APIを呼べばよく、裏側の実装は検索チームが差し替えられます。デプロイは検索側で完結します。インタフェースやデータの投入口を変えるときだけ、本体側のリクエスト処理や更新処理まで検索チームが担います。専門性の高い検索の問題を、検索ドメインの中で完結して解ける状態です。検索を独立したプロダクトとして扱える、というのがいまの進め方の前提です。
3. Solr から Elasticsearch への載せ替えを、検索チームのペースで進める
独立して案件を進められるようになった具体例が、現在進行中の Solr から Elasticsearch への移行です。
【当時の課題】
商品検索を支えているのは Apache Solr です。GCP 上で同一データを持つ2クラスタ、合計24ノードの冗長構成です。スケールや運用の柔軟性を上げたくても、本体と結合したままではエンジンごと変える判断は現実的ではありませんでした。
いまは同じ GCP 上で、Elasticsearch への置き換えを検証・構築しています。
【移行で外せない要件】
- 出品中約630万点の商品を対象にした全文検索
- ブランド・カテゴリ・価格などのファセット
- 現行に近い並び順・グループ化
- ピーク約400 RPS でも、ユーザー向けの応答速度を維持すること
- インデックスの洗い替えのために検索を止めないこと
【解決へのアプローチ】
- エンジン選定
フルマネージドの検索サービスも検討しましたが、ファセットや複雑なソートを現行どおり載せるには、カスタマイズの余地が足りませんでした。既存の GCP 環境との統合のしやすさも踏まえ、Elasticsearch を GKE 上で運用する方針にしています - クラスタ構成
Solr では安定運用のために必要だった2クラスタの冗長構成を、Elasticsearch では1クラスタにまとめる想定です - 検索APIの刷新
検索APIとデータ投入も検索システム側で作り直しています。本体向けのインタフェースは現行に合わせつつ、裏側は Solr 前提の実装から切り離します。現行の検索APIは Python で、CPU 使用率が高く、アクセスが増えると 20〜30 インスタンスが起動し、コストも増えやすい状態です。新しいAPIは Go に書き換え、Cloud Run 上に設置済みですが、本番トラフィックの切替はこれからです - クエリの見直し
Solr 向けのクエリをそのまま写したところ、見た目の検索結果は近づけたつもりでも、本番相当の負荷をかけるとおよそ200 RPS で頭打ちし、ノードの CPU が飽和しました。現行の検索体験は残したまま何度もクエリの組み立てを見直し、ピーク約400 RPS の要件に乗せられたときは大きな達成感がありました
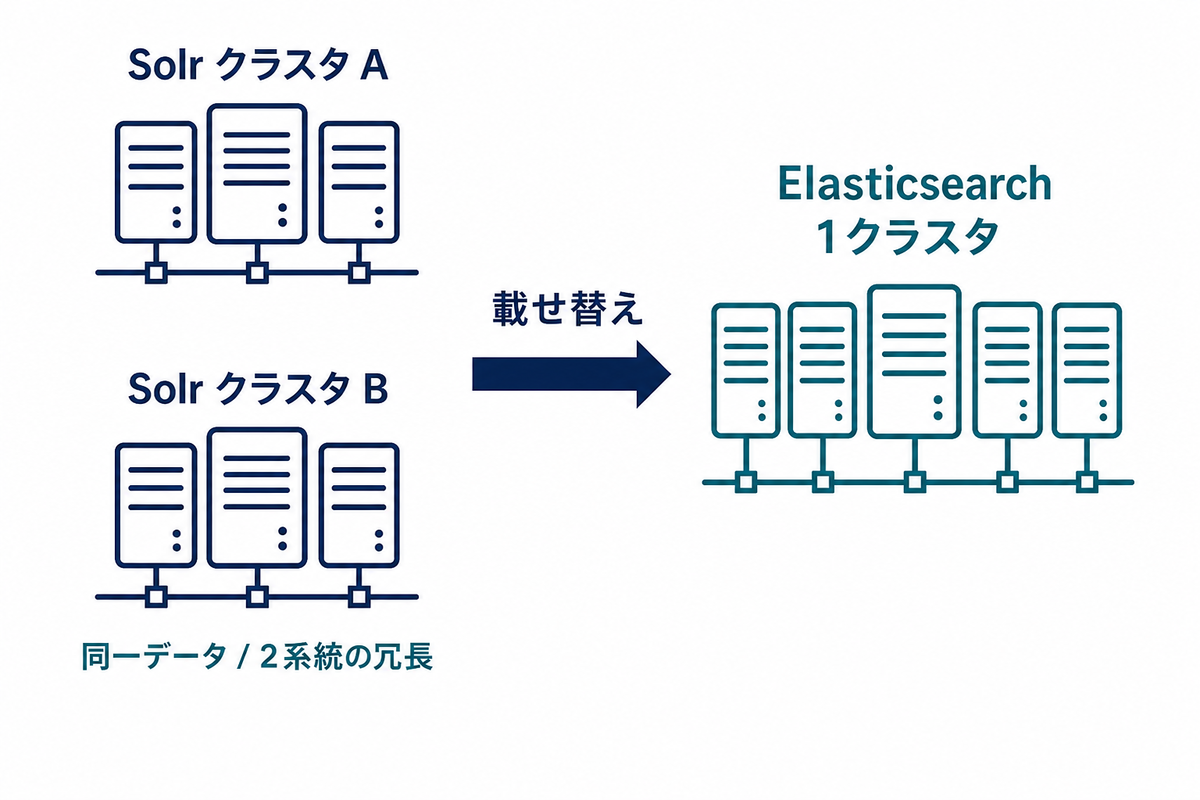
検索がマイクロサービスとして独立しているからこそ、現行 Solr を止めずに並行して検証し、検索チームのペースで載せ替えを進められています。
MLOps:モデルを「定期的に、安全に」本番へ載せる
検索チームは、もともと検索エンジニアリングの専任でした。
推薦や機械学習の案件が増えるにつれて、モデルを本番で動かし続ける基盤、いわゆる MLOps も担当するようになりました。
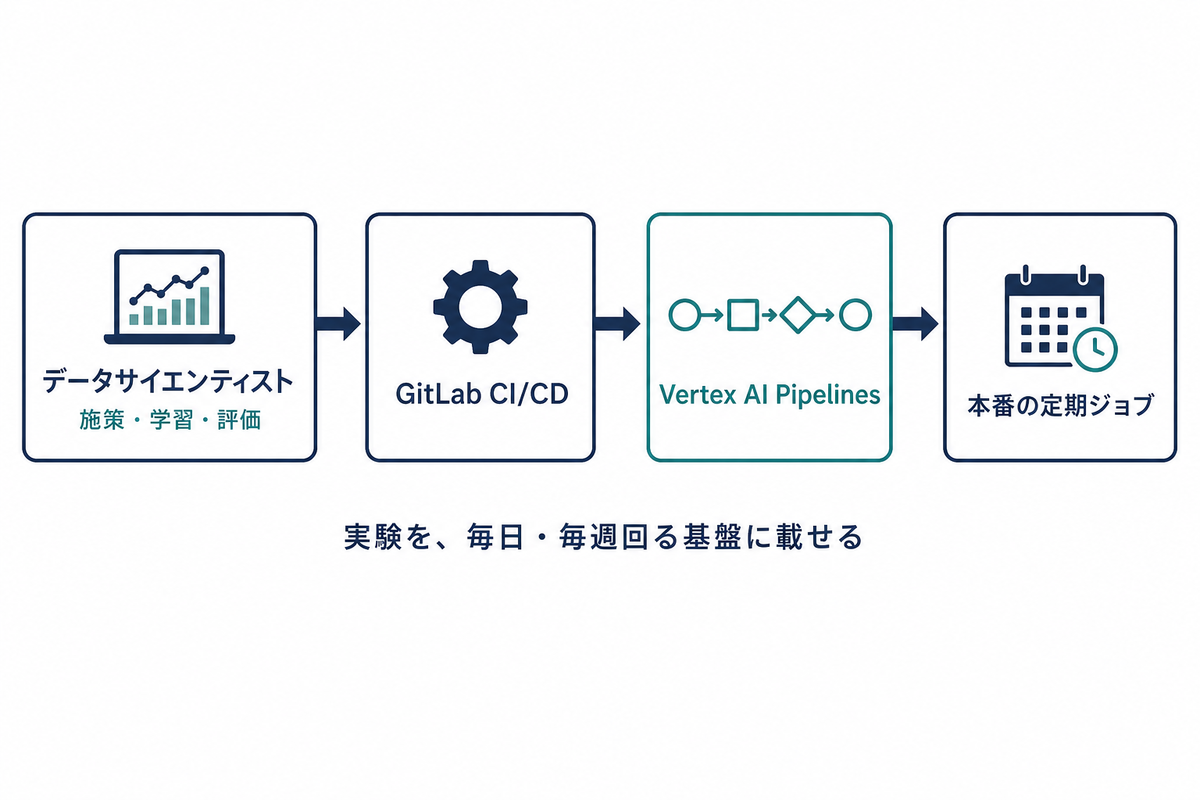
実験を本番の定期ジョブに載せ、運用を回す
【役割分担】
データサイエンティストは、施策の設計、特徴量、学習、評価を担います。検索チームは、その成果物がオンラインの推論でも、毎日・毎週のバッチでも、想定した品質で動き続けるための実行基盤を担います。
不正検知については、分析・導入判断の経緯を別記事でも紹介しています。検索チームの役割は、そうしたモデルを「検証で終わらせず、運用に耐えるサービス」にする側です。
- 対応例: 不正対策の機械学習導入までに検証したこと
【基盤の構成】
学習・推論は Vertex AI Pipelines(Kubeflow Pipelines)上のパイプラインとして定義し、前処理・学習・予測・評価などのコンポーネントはコンテナイメージとしてバージョン管理します。GitLab CI/CD でテスト、ビルド、デプロイまでつなぎ、推論結果を下流のサービスやバッチが受け取れる形で届けます。
パイプラインには、推薦や不正対策、定期バッチで回すスコア系など、オンラインの推論とバッチの両方を載せています。
【いちばん詰まったところ:バージョン整合】
パイプライン定義、コンポーネント、下流のジョブで共通ライブラリを使い回すときのバージョン整合です。片方だけ新しいイメージに載せ替えると、学習は通っても、推論側で想定どおり動かないことがあります。派手な障害ではないのですが、原因の切り分けに時間がかかるタイプです。コンポーネントとパイプラインのバージョンを分け、共通ライブラリの整合を取りながら回すようにしたことで、大きな安心感を得られました。
【この領域の面白さ】
機械学習システムは、一度出せば終わりではありません。データが変わり、モデルが更新され、しきい値も動きます。そのたびに同じ品質で出し直せる状態を維持します。レスポンス速度や可用性、セキュリティは、検索APIと同じ目線で設計します。
ここでの面白さは、アルゴリズムそのものというより、実験を本番の定期ジョブに載せ、運用を回せる状態にすることです。
AIシステムの開発・PoC
以前は検索運用と MLOps が主でしたが、生成AIの API が実用的になったこともあり、AI を使ったシステムの開発や PoC も担当するようになっています。
テキストや画像を対象にしたチェック処理を本番に載せるほか、商品検索とつながる「AIでさがす」にも関わっています。
生成AIによる感情分析・各種チェック
【対象にしているもの】
BUYMA は、出品者と購入者がメッセージを交わす CtoC の場でもあります。正当な商品のやりとり(在庫、サイズ、色味、配送追跡、公式サイトとの照合)と、スパム・フィッシング・外部誘導を切り分ける必要があります。
【ルールベースだけでは足りない理由】
ルールベースだけでは、新しい手口に追いつけません。逆に「外部URLがある」「BUYMA の外のサイトだ」だけで止めると、正常な購入会話まで不可となってしまいます。
【実装しているチェック】
検索チームでは Gemini を使い、次のようなチェックをマイクロサービスとして実装しています。
- 問い合わせメッセージのスパム・フィッシング判定
- 感情分析など、テキストのトーンやリスクを見る処理
- 画像に含まれる、外部サイトへの誘導につながりやすい要素の検出
【運用上の判断】
同期の API と、まとめて処理するバッチの両方があります。過検知と見逃しのどちらを許容するかは、カスタマーサポートや不正対策の運用チームとすり合わせます。モデルの世代が上がったときは、精度・速度・コストのバランスを見て載せ替えるかどうかを決めます。速いが高コスト、あるいは高精度だがレイテンシが合わない、といった上位モデルを見送る判断もここに含まれます。
【BUYMAドメインの制約】
検索で「現行の体験を維持したまま裏側を差し替える」のと同じで、生成AIでも、まずドメインの制約から設計します。ファッションの CtoC では、韓国・欧米の正規 EC の URL や配送会社の追跡リンクは日常的に登場します。その文脈を無視した汎用のスパム判定では、実運用には耐えません。
生成AIと商品検索の接点:「AIでさがす」
BUYMA の「AIでさがす」は、記事コンテンツを根拠にした提案へと進化しています。
ここは、検索チームが運用する商品検索APIと、生成AI側のキーワード生成・文書検索が接続する領域です。検索基盤が独立していることで、AI 側の変更と、商品検索エンジン側の変更を並行して進められます。
- 対応例: 「AIでさがす」サービスのリニューアル
これから取り組むこと
検索チームとして、目の前にある大きな業務は次のようなものです。
- Elasticsearch の品質確認と、Go 製検索APIを含めたトラフィックの段階的な切替
- 独立した検索基盤の上で、検索結果の精度をよりよくしていくこと
- 推薦・不正検知などの ML パイプラインを、より安定して回し、より載せやすくすること
- 生成AIのチェックや AI 検索を、既存の検索・ML 基盤と無理なくつなぐこと
「完成した基盤を保守する」フェーズではありません。切り離した検索プラットフォームの上で、エンジンも ML も AI も、まだ載せ替えと拡張の途中にあります。新メンバーには、アーキテクチャ設計から主導していただく余地が十分にあります。
インフラから API、データ、評価までを、同じチームで担っているのも醍醐味の一つです。
さいごに
検索チームは、出品中約630万点を支える商品検索をはじめ、BUYMA の検索を止めないことと、機械学習と生成AIを本番に載せることを並行して実施しています。
2024年の GCP 移設で検索APIを境界にして商品検索を独立させたことが、いまの Elasticsearch 移行のような「検索単体の大きな案件」を可能にしています。
現在は検索チームとしての幅を広げ、検索基盤・MLOps・生成AIまでを見ています。
今後はデータ基盤チーム等と統合し、よりプラットフォーム全体を見る体制へ変遷していく予定です。検索に閉じず、データを集め、モデルを回し、サービスとして届けるところまでを同じ視点で扱える場が、さらに広がっていくと考えています。
ここまで、いま私たちが担当しているものと、これから広がっていく業務の範囲を書いてきました。少しでも業務イメージが伝われば幸いです。
株式会社エニグモ すべての求人一覧
